📊 Graphiques, 📦collections (set, tuple, dict)
- For (séquence)
- Compréhension de liste
- Ensemble (set)
- Tuple (tuple)
- Dictionnaire (dict)
- Matplotlib
- Activités
for sur une listeÀ la rencontre 5, on a parcouru des listes avec for i in range(len(liste)) et liste[i] pour accéder à l'élément à l'index i.
Il existe une façon plus directe et plus lisible : parcourir les éléments directement, sans passer par l'index.
La syntaxe est la suivante :
for element in liste:
    # instructions à exécuter
Voici un exemple avec une liste d'éléments chimiques :
elements = ["Hydrogène", "Oxygène", "Carbone", "Azote"]
for element in elements:
    print("Élément :", element)
Élément : Hydrogène
Élément : Oxygène
Élément : Carbone
Élément : Azote
À chaque tour de boucle, la variable element prend automatiquement la valeur de l'élément suivant dans la liste.
Son nom est libre : on aurait pu l'appeler e, chimique, ou n'importe quoi d'autre. C'est nous qui choisissons.
👉 Exécutez ce code en mode débogage. Mettez un point d'arrêt sur la ligne 2 et avancez une ligne à la fois pour suivre l'évolution de la variable element.
for et range(len()) : ce qu'on connaissait déjàLes deux versions ci-dessous produisent exactement le même résultat :
Boucle for sur la liste
elements = ["Hydrogène", "Oxygène", "Carbone", "Azote"]
for element in elements:
    print("Élément :", element)
Boucle for avec range(len())
elements = ["Hydrogène", "Oxygène", "Carbone", "Azote"]
for i in range(len(elements)):
    element = elements[i]
    print("Élément :", element)
La version for element in elements est plus concise et plus facile à lire, surtout quand on n'a pas besoin de l'index.
for element in elements: quand on veut traiter chaque élément et qu'on n'a pas besoin de l'index.for i in range(len(elements)): quand on a besoin de l'index pour modifier la liste ou comparer des positions.while: quand la condition d'arrêt est plus complexe qu'un simple parcours de liste.
La syntaxe for element in elements est pratique, mais elle ne permet pas de parcourir deux listes en parallèle, puisqu'on n'a pas accès à l'index.
Dans ce cas, il faut revenir à for i in range(len(...)) :
elements         = ["Hydrogène", "Oxygène", "Carbone", "Azote"]
masses_atomiques = [1.008,       15.999,    12.011,    14.007]

# ❌ Impossible avec for element in elements : pas d'accès à l'index
for element in elements:
    print(f"{element} a une masse atomique de {masses_atomiques[???]}")  # On ne connaît pas l'index!

# ✅ Utiliser range() pour accéder aux deux listes via l'index
for i in range(len(elements)):
    print(f"{elements[i]} a une masse atomique de {masses_atomiques[i]}")
Hydrogène a une masse atomique de 1.008
Oxygène a une masse atomique de 15.999
Carbone a une masse atomique de 12.011
Azote a une masse atomique de 14.007
append()Une boucle for sur une liste est souvent utilisée pour construire une nouvelle liste à partir d'une liste existante.
Voici un exemple qui crée une liste de descriptions à partir de la liste d'éléments chimiques :
elements = ["Hydrogène", "Oxygène", "Carbone", "Azote"]
descriptions = []
for element in elements:
    descriptions.append(f"{element} est un élément chimique.")  # Ajoute une description à la liste
print(descriptions)
['Hydrogène est un élément chimique.', 'Oxygène est un élément chimique.', 'Carbone est un élément chimique.', 'Azote est un élément chimique.']
👉 Exécutez-le en mode débogage pour suivre l'évolution de la liste descriptions à chaque itération.
enumerate() pour obtenir l'index et la valeur en même tempsParfois, on a besoin à la fois de l'index et de la valeur de chaque élément.
La fonction enumerate() permet d'obtenir les deux sans avoir à gérer i manuellement :
elements = ["Hydrogène", "Oxygène", "Carbone", "Azote"]
for index, element in enumerate(elements):
    print(f"Élément #{index} : {element}")
Élément #0 : Hydrogène
Élément #1 : Oxygène
Élément #2 : Carbone
Élément #3 : Azote
👉 Exécutez-le en mode débogage pour suivre l'évolution des variables index et element à chaque itération.
Les explications de cette section étaient-elles claires ?
Imaginons qu'on veuille créer une nouvelle liste contenant le carré de chaque nombre d'une liste. Avec une boucle for classique, ça ressemble à ceci :
nombres = [1, 2, 3, 4, 5, 6]
carres = []
for x in nombres:
    carres.append(x ** 2)
print(carres)  # Affiche [1, 4, 9, 16, 25, 36]
C'est correct, mais ça prend 3 lignes juste pour construire la liste. La compréhension de liste permet d'écrire la même chose en une seule ligne.
La compréhension de liste est une manière concise et élégante de créer des listes en Python. Elle permet de générer une nouvelle liste en appliquant une expression à chaque élément d'une séquence (comme une liste, un tuple, etc.).
La syntaxe générale est la suivante :
nouvelle_liste = [expression for element in sequence]
Voici comment réécrire l'exemple précédent avec une compréhension de liste :
nombres = [1, 2, 3, 4, 5, 6]
carres = [x ** 2 for x in nombres]
print(carres)  # Affiche [1, 4, 9, 16, 25, 36]
Chaque partie de [x ** 2 for x in nombres] a un rôle précis :
#  ┌─ expression ─┐        ┌─ element ─┐  ┌── sequence ──┐
  [     x ** 2        for        x      in    nombres     ]
expression(x ** 2) : la transformation à appliquer à chaque élément.element(x) : la variable qui prend chaque valeur de la séquence.sequence(nombres) : la liste qu'on parcourt.
Exécutez ce code en mode débogage pour bien comprendre son fonctionnement.
On peut aussi ajouter une condition optionnelle pour ne garder que certains éléments :
nouvelle_liste = [expression for element in sequence if condition]
Par exemple, pour ne garder que les carrés des nombres pairs :
nombres = [1, 2, 3, 4, 5, 6]
carres_pairs = [x ** 2 for x in nombres if x % 2 == 0]
print(carres_pairs)  # Affiche [4, 16, 36]
#  ┌─ expression ─┐        ┌─ element ─┐  ┌── sequence ──┐  ┌──── condition ────┐
  [     x ** 2        for        x      in     nombres    if    x % 2 == 0       ]
Le même résultat avec une boucle for classique :
nombres = [1, 2, 3, 4, 5, 6]
carres_pairs = []
for x in nombres:
    if x % 2 == 0:
        carres_pairs.append(x ** 2)
print(carres_pairs)  # Affiche [4, 16, 36]
Les deux approches produisent exactement le même résultat.
La compréhension de liste est simplement une façon plus compacte d'écrire ce même code.
- Concision : La compréhension de liste permet d'écrire moins de lignes de code pour accomplir la même tâche.
- Lisibilité : Elle rend le code plus lisible en exprimant clairement l'intention de créer une nouvelle liste basée sur une transformation ou un filtrage.
- Performance : La compréhension de liste est souvent plus rapide que l'utilisation de boucles
fortraditionnelles pour créer des listes.
Il est possible d'imbriquer des compréhensions de liste à l'intérieur d'autres compréhensions de liste.
Ce concept, appelé nested list comprehensions, n'est pas requis dans le cadre de ce cours, mais il est bon de savoir que ça existe.
👉 Si ce qui suit semble difficile à suivre, c'est tout à fait normal. Cette notion dépasse les attentes du cours. Vous pouvez passer directement à l'onglet suivant sans culpabiliser.
Une compréhension de liste imbriquée, c'est simplement une compréhension de liste dont l'expression
est elle-même une compréhension de liste. Par exemple, pour créer une liste de listes :
liste = [[j for j in range(i)] for i in range(5)]
print(liste)  # Affiche [[], [0], [0, 1], [0, 1, 2], [0, 1, 2, 3]]
La compréhension extérieure (for i in range(5)) génère 5 éléments.
Pour chaque valeur de i, la compréhension intérieure ([j for j in range(i)]) crée une sous-liste contenant les entiers de 0 à i - 1.
Le même résultat avec des boucles for classiques :
liste = []
for i in range(5):
    sous_liste = []
    for j in range(i):
        sous_liste.append(j)
    liste.append(sous_liste)
print(liste)  # Affiche [[], [0], [0, 1], [0, 1, 2], [0, 1, 2, 3]]
Les explications de cette section étaient-elles claires ?
Un ensemble (set) est une collection non ordonnée d'éléments uniques.
Contrairement à une liste, un ensemble ne peut pas contenir de doublons et ses éléments n'ont pas d'index.
On l'utilise quand l'ordre n'a pas d'importance et qu'on veut garantir qu'un élément n'apparaît qu'une seule fois,
ou effectuer des opérations mathématiques comme l'union, l'intersection et la différence.
On crée un ensemble avec des accolades {} et des valeurs séparées par des virgules :
heros = {"Peach", "Link", "Kirby"}
{} crée un dictionnaire, pas un ensemble.
Pour créer un ensemble vide, il faut utiliser set() :
heros = set()
On utilise .add() pour ajouter un élément. Si l'élément est déjà présent, il ne sera pas ajouté en double :
heros = {"Peach", "Link", "Kirby"}
heros.add("Kirby")   # Ignoré, déjà présent
heros.add("Yoshi")   # Ajouté
print(heros)         # Résultat possible : {"Yoshi", "Kirby", "Peach", "Link"}
print(heros)         # Résultat possible : {"Link", "Peach", "Yoshi", "Kirby"}
L'ordre des éléments peut varier d'un print à l'autre. Un ensemble ne garantit aucun ordre précis.
On utilise remove() pour supprimer un élément d'un ensemble :
heros = {"Peach", "Yoshi", "Kirby"}
heros.remove("Yoshi")
print(heros)  # {"Peach", "Kirby"} (ordre variable)
On peut vérifier si un élément est dans un ensemble avec in :
nombres = {1, 2, 3, 4, 5}

print(3 in nombres)  # True
print(9 in nombres)  # False
👉 La vérification avec in est particulièrement rapide sur un ensemble, plus que sur une liste.
On peut obtenir le nombre d'éléments d'un ensemble avec len() :
nombres = {1, 2, 3, 4, 5}

print(len(nombres))  # 5
Pour convertir un ensemble en une liste, il suffit d'appeler la fonction list() en passant l'ensemble en paramètre.
mon_ensemble = {1, 2, 3, 4}
ma_liste = list(mon_ensemble)
print(f"Ma liste : {ma_liste}") # Ma liste : [1, 2, 3, 4] (ordre variable)
Pour convertir une liste en un ensemble, il suffit d'appeler la fonction set() en passant la liste en paramètre.
ma_liste = [1, 2, 2, 3, 4]
mon_ensemble = set(ma_liste)
print(f"Mon ensemble : {mon_ensemble}")  # Mon ensemble : {1, 2, 3, 4} (ordre variable)
On remarque que les doublons de la liste ont été automatiquement supprimés lors de la conversion en ensemble.
Cette propriété est très utile pour éliminer les répétitions d'une liste.
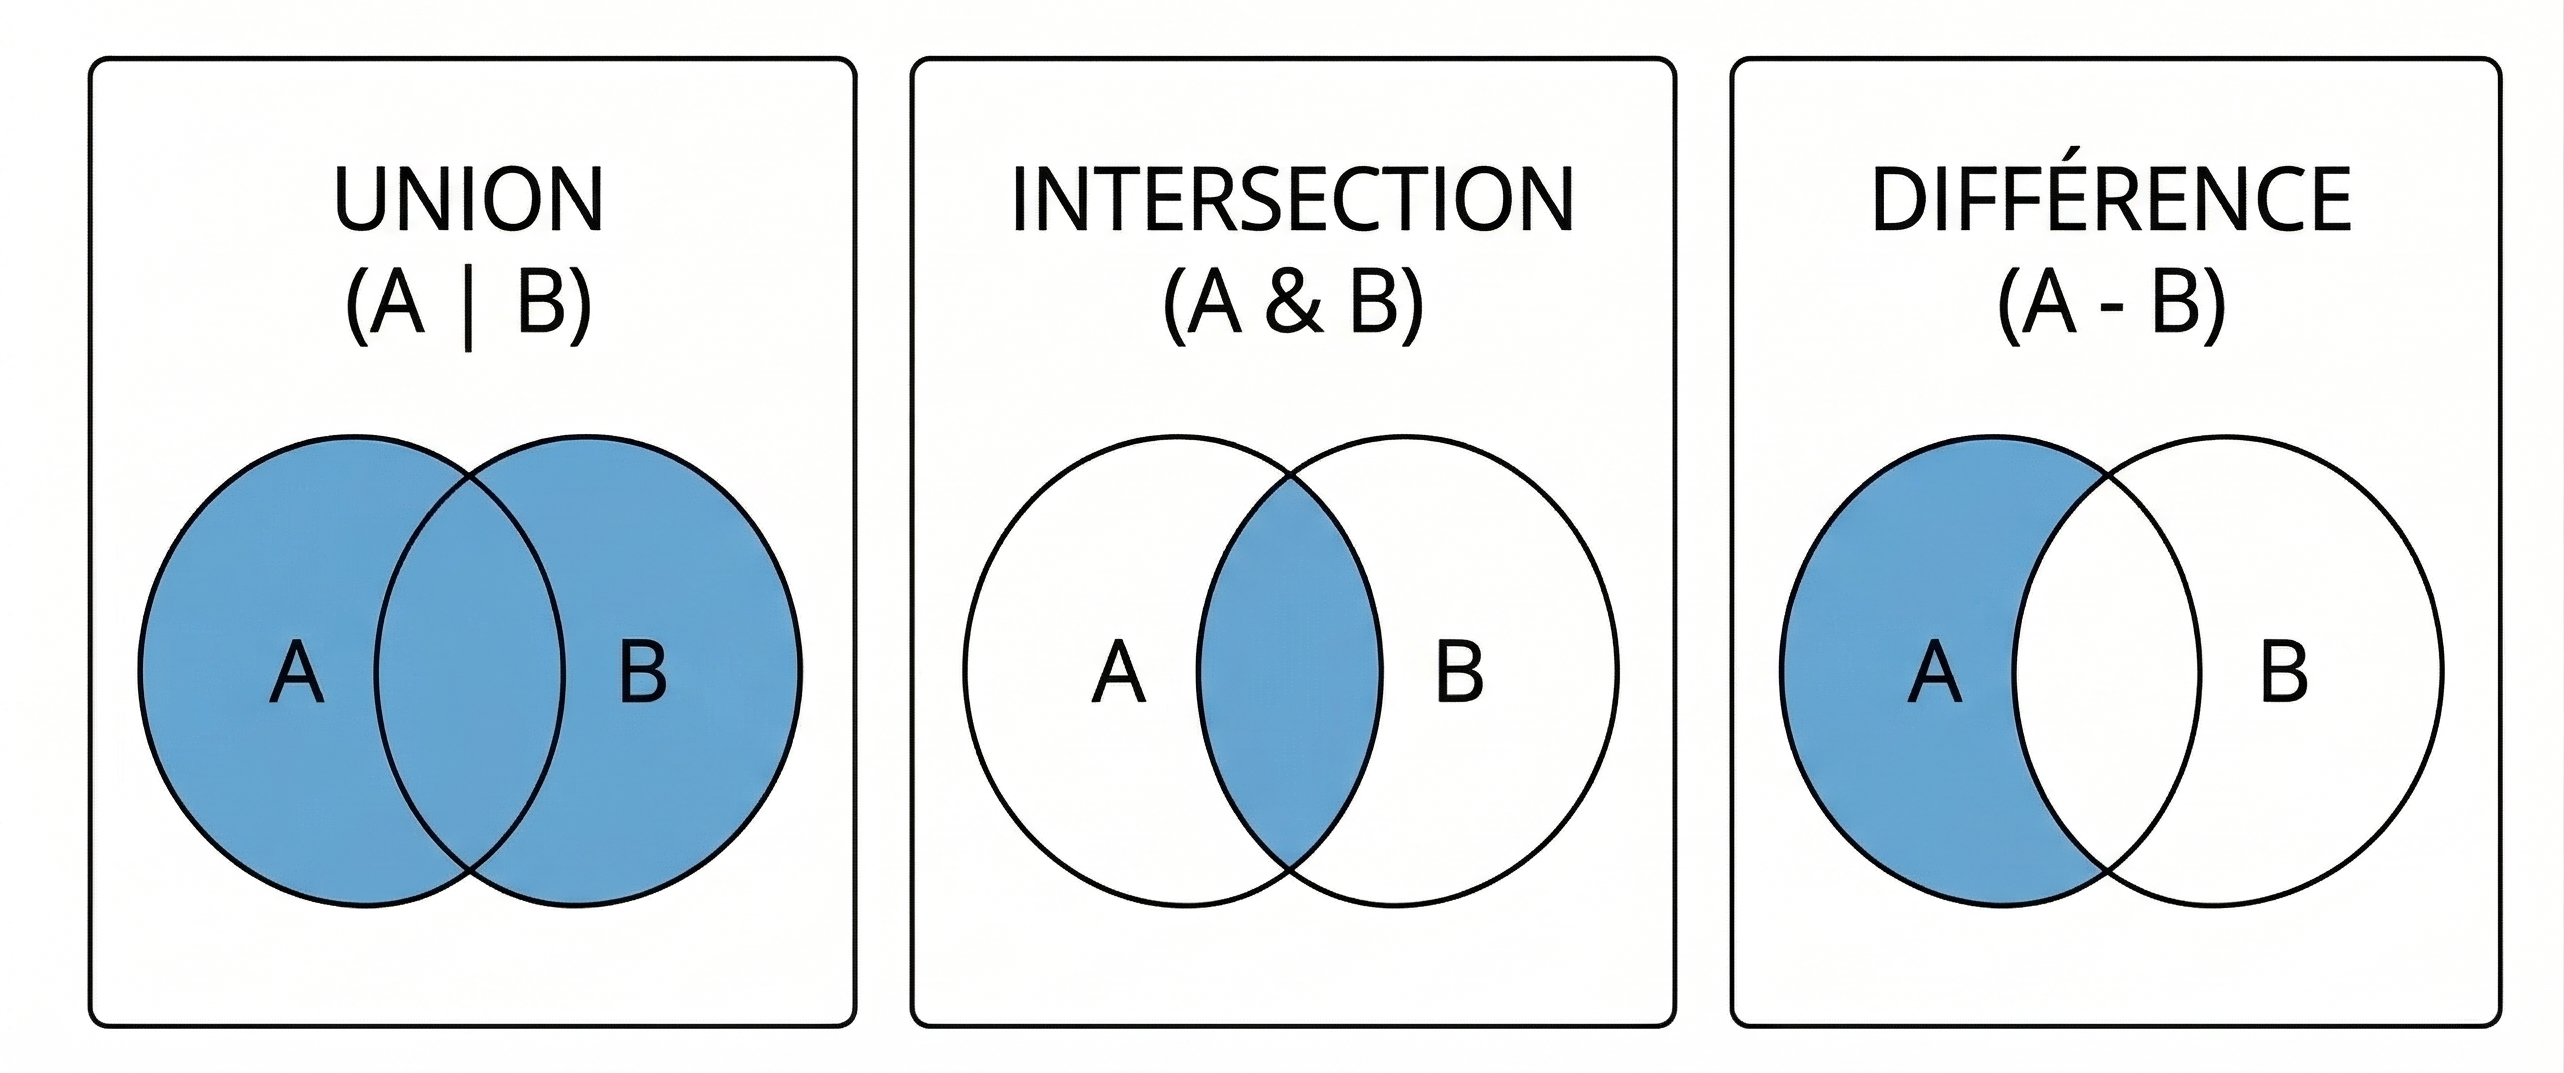
On peut combiner deux ensembles avec des opérateurs mathématiques :
groupe_a = {1, 2, 3}
groupe_b = {3, 4, 5}
Union | : tous les éléments des deux ensembles réunis, sans doublons. Comme si on fusionnait deux groupes en retirant les répétitions.
print(groupe_a | groupe_b) # {1, 2, 3, 4, 5}
Intersection & : uniquement les éléments présents dans les deux ensembles à la fois. Ce qu'ils ont en commun.
print(groupe_a & groupe_b) # {3}
Différence - : les éléments qui sont dans le premier ensemble mais pas dans le second. Ce que le premier a en exclusivité.
print(groupe_a - groupe_b) # {1, 2}
On peut parcourir les éléments d'un ensemble avec une boucle for :
heros = {"Peach", "Yoshi", "Kirby"}
for hero in heros:
    print(hero)
Contrairement aux listes, un ensemble ne conserve aucun ordre.
À chaque exécution, les éléments peuvent apparaître dans un ordre différent :
# Exécution 1 :
Kirby
Peach
Yoshi

# Exécution 2 :
Yoshi
Kirby
Peach

# Exécution 3 :
Peach
Yoshi
Kirby
Si l'ordre est important, on utilise une liste plutôt qu'un ensemble.
KeyError Se produit lorsqu'on tente de supprimer un élément absent avec remove() :
heros = {"Peach", "Yoshi", "Kirby"}
heros.remove("Pikachu")  # ❌ KeyError: 'Pikachu'
Pour éviter cette erreur, on vérifie d'abord que l'élément est présent avec in, ou on utilise discard() :
if "Pikachu" in heros:
    heros.remove("Pikachu")

# ou plus simplement :
heros.discard("Pikachu")  # Ne fait rien si absent
Les ensembles sont très utiles pour :
- Éliminer les doublons d'une liste (convertir une liste en ensemble supprime automatiquement les répétitions).
- Vérifier rapidement si un élément est présent dans une collection (plus rapide qu'une liste).
- Effectuer des opérations mathématiques sur des groupes de données : union, intersection, différence.
Ensemble non ordonné et sans doublons, défini avec des accolades {}.
| Opération | Syntaxe | Description |
|---|---|---|
| Créer | couleurs = {"rouge", "vert", "bleu"} | Nouvel ensemble |
| Créer (vide) | couleurs = set() | Ensemble vide (pas {}) |
| Présence | est_present = "rouge" in couleurs | Retourne True ou False |
| Ajouter | couleurs.add("jaune") | Ajoute un élément (sans doublon) |
| Supprimer (erreur si absent) | couleurs.remove("vert") | Lève une erreur si absent |
| Supprimer (sans erreur) | couleurs.discard("vert") | Ne fait rien si absent |
| Union | ensemble_union = a | b | Tous les éléments des deux ensembles |
| Intersection | ensemble_commun = a & b | Éléments communs aux deux ensembles |
| Différence | ensemble_diff = a - b | Éléments dans a mais pas dans b |
| Convertir en liste | ma_liste = list(couleurs) | Transforme l'ensemble en liste |
| Convertir une liste en ensemble | couleurs = set(ma_liste) | Transforme une liste en ensemble (sans doublons) |
| Longueur | nb_elements = len(couleurs) | Nombre d'éléments |
Les explications de cette section étaient-elles claires ?
Un tuple est une collection ordonnée et immuable d'éléments.
Contrairement à une liste, un tuple ne peut pas être modifié après sa création : on ne peut pas ajouter, retirer ou remplacer ses éléments.
Il est défini avec des parenthèses () :
coordonnees = (10, 20)
On l'utilise quand les valeurs sont fixes par nature : des coordonnées, une date, les dimensions d'une image.
Le fait qu'il soit immuable est une garantie que ces valeurs ne changeront pas accidentellement.
On crée un tuple avec des parenthèses () et des valeurs séparées par des virgules :
mon_tuple = (1, 2, 3, "quatre", True)
Les parenthèses sont optionnelles : Python reconnaît le tuple grâce aux virgules.
mon_tuple = 1, 2, 3, "quatre", True
On peut transformer une liste existante en tuple avec la fonction tuple() :
ma_liste = [1, 2, 3]
mon_tuple = tuple(ma_liste)
print(mon_tuple)  # Résultat : (1, 2, 3)
On peut transformer un tuple en une liste avec la fonction list() :
mon_tuple = (1, 2, 3)
ma_liste = list(mon_tuple)
print(ma_liste)  # Résultat : [1, 2, 3]
On peut accéder aux éléments d'un tuple en utilisant des indices, de la même manière que pour les listes :
mon_tuple = (10, 20, 30, 40, 50)
print(mon_tuple[0])  # Résultat : 10
print(mon_tuple[2])  # Résultat : 30
Comme les listes, les indices négatifs fonctionnent aussi :
print(mon_tuple[-1])  # Résultat : 50
print(mon_tuple[-3])  # Résultat : 30
Cependant, comme les tuples sont immuables (contrairement aux listes), on ne peut pas modifier leurs éléments :
mon_tuple[0] = 100 # Cela provoquera une erreur
On peut vérifier si une valeur est dans un tuple avec in :
coordonnees = (10, 20, 30)

print(10 in coordonnees)  # True
print(99 in coordonnees)  # False
On peut affecter chaque valeur d'un tuple à une variable distincte en une seule ligne.
Le nombre de variables doit correspondre exactement au nombre d'éléments :
coordonnees = (10, 20, 30)
x, y, z = coordonnees

print(x)  # 10
print(y)  # 20
print(z)  # 30
Une fonction qui retourne plusieurs valeurs utilise souvent un tuple pour les regrouper.
- Les parenthèses sont souvent omises après le
return. - Les valeurs retournées peuvent être soit capturées dans une seule variable (un tuple), soit décomposées en plusieurs variables, ce qui est très pratique.
def calculer_operations(a, b):
    somme = a + b
    produit = a * b
    return somme, produit  # Retourne un tuple (somme, produit)

resultat = calculer_operations(3, 5)
print(resultat)  # Résultat : (8, 15)

somme, produit = calculer_operations(3, 5)
print(somme)     # Résultat : 8
print(produit)   # Résultat : 15
TypeError Se produit lorsqu'on tente de modifier un élément d'un tuple. Les tuples sont immuables, cette opération est donc interdite :
mon_tuple = (10, 20, 30)
mon_tuple[0] = 100  # ❌ TypeError: 'tuple' object does not support item assignment
IndexError Se produit lorsqu'on tente d'accéder à un index inexistant :
mon_tuple = (10, 20, 30)
print(mon_tuple[5])  # ❌ IndexError: tuple index out of range
Les tuples sont très utiles pour :
- Regrouper des valeurs liées qui ne doivent pas changer (coordonnées GPS, dimensions, date).
- Retourner plusieurs valeurs depuis une fonction de façon claire et concise.
- Décomposer plusieurs variables en une seule ligne grâce à l'affectation multiple.
Liste ordonnée et immuable, définie avec des parenthèses ().
| Opération | Syntaxe | Description |
|---|---|---|
| Créer | coordonnees = (10, 20) | Nouveau tuple |
| Créer (sans parenthèses) | coordonnees = 10, 20 | Équivalent avec parenthèses implicites |
| Convertir une liste | mon_tuple = tuple(ma_liste) | Transforme une liste en tuple |
| Convertir en liste | ma_liste = list(mon_tuple) | Transforme un tuple en liste |
| Accéder | element = coordonnees[0] | Élément à l'index 0 |
| Indice négatif | dernier = coordonnees[-1] | Dernier élément |
| Longueur | nb_elements = len(coordonnees) | Nombre d'éléments |
| Présence | est_present = 10 in coordonnees | Retourne True ou False |
| Décomposer | x, y = coordonnees | Assigne chaque élément à une variable |
| Retour multiple | return a, b | Retourne plusieurs valeurs (tuple implicite) |
Les explications de cette section étaient-elles claires ?
Un dictionnaire associe chaque clé à une valeur, un peu comme un dictionnaire papier où chaque mot est associé à une définition.
On peut accéder rapidement à une valeur en connaissant sa clé.
Par exemple, on peut stocker les données d'une expérience de chimie :
- la clé
"nom"est associée à la valeur"Électrolyse de l'eau"(str) - la clé
"tentative"est associée à la valeur2(int) - la clé
"tension_volts"est associée à la valeur1.5(float) - la clé
"succes"est associée à la valeurTrue(bool) - la clé
"gaz_produits"est associée à la valeur["hydrogène", "oxygène"](list)
On utilise des accolades {}, avec les clés et valeurs séparées par : et chaque paire séparée par une virgule , :
experience = {
    "nom": "Électrolyse de l'eau",
    "tentative": 2,
    "tension_volts": 1.5,
    "succes": True,
    "gaz_produits": ["hydrogène", "oxygène"]
}
On peut aussi partir d'un dictionnaire vide et y ajouter des paires clé-valeur une à une :
experience = {}
experience["nom"] = "Électrolyse de l'eau"
experience["tentative"] = 2
experience["tension_volts"] = 1.5
experience["succes"] = True
experience["gaz_produits"] = ["hydrogène", "oxygène"]
On accède à la valeur associée à une clé en utilisant les crochets [] :
experience = {"nom": "Électrolyse de l'eau", "tentative": 2, "succes": True}
print(experience["nom"])       # Résultat : Électrolyse de l'eau
print(experience["tentative"]) # Résultat : 2
On peut modifier la valeur associée à une clé existante de la même façon :
experience["tentative"] = 3
print(experience["tentative"])  # Résultat : 3
Pour supprimer une paire clé-valeur d'un dictionnaire, on utilise le mot-clé del suivi de la clé à supprimer :
experience = {"nom": "Électrolyse de l'eau", "tentative": 2, "succes": True}
del experience["succes"]
print(experience)  # Résultat : {'nom': "Électrolyse de l'eau", 'tentative': 2}
- Les clés dans un dictionnaire doivent être de types immuables (comme les chaînes de caractères, les nombres ou les tuples immuables).
- Les valeurs peuvent être de n'importe quel type, y compris des listes, des ensembles, des tuples ou même d'autres dictionnaires.
experience = {
    "nom": "Électrolyse de l'eau",            # clé str, valeur str
    "tentative": 2,                           # clé str, valeur int
    "tension_volts": 1.5,                     # clé str, valeur float
    "succes": True,                           # clé str, valeur bool
    "gaz_produits": ["hydrogène", "oxygène"]  # clé str, valeur list
    "auteurs": {                              # clé str, valeur dict
        "Alice": "chercheuse principale",
        "Bob": "assistant"
    }
}
On peut vérifier si une clé existe dans un dictionnaire avec in :
experience = {"nom": "Électrolyse de l'eau", "tentative": 2, "succes": True}

print("nom" in experience)          # True
print("temperature" in experience)  # False
⚠️ in vérifie les clés uniquement, pas les valeurs.
On peut obtenir le nombre de paires clé: valeur avec len() :
experience = {"nom": "Électrolyse de l'eau", "tentative": 2, "succes": True}

print(len(experience))  # 3
Trois méthodes permettent d'accéder au contenu d'un dictionnaire :
.keys(): retourne toutes lesclésdu dictionnaire..values(): retourne toutes lesvaleursdu dictionnaire..items(): retourne toutes les paires(clé, valeur)sous forme de tuples.
Ces méthodes retournent des types spéciaux (dict_keys, dict_values, dict_items) qui se comportent comme des listes pour l'itération.
On peut les parcourir directement avec une boucle for, comme on le verra dans la section suivante.
On peut parcourir un dictionnaire avec une boucle for de trois manières selon ce dont on a besoin.
Sur les clés : .keys()
experience = {"nom": "Électrolyse de l'eau", "tentative": 2, "succes": True}

for cle in experience.keys():  # cle → "nom", puis "tentative", puis "succes"
    print(cle)
nom
tentative
succes
Sur les valeurs : .values()
for valeur in experience.values():  # valeur → "Électrolyse de l'eau", puis 2, puis True
    print(valeur)
Électrolyse de l'eau
2
True
Sur les paires clé-valeur : .items()
for cle, valeur in experience.items():  # ("nom", "Électrolyse de l'eau"), puis ("tentative", 2), puis ("succes", True)
    print(f"{cle} : {valeur}")
nom : Électrolyse de l'eau
tentative : 2
succes : True
KeyError Levée dans deux situations : quand on accède à une clé inexistante ou quand on tente de la supprimer :
experience = {"nom": "Électrolyse de l'eau", "tentative": 2}

print(experience["temperature"])   # KeyError: 'temperature'
del experience["temperature"]      # KeyError: 'temperature'
Pour éviter cette erreur, on vérifie d'abord que la clé est présente avec in :
if "temperature" in experience:
    print(experience["temperature"])
    del experience["temperature"]
Les dictionnaires sont très utiles pour :
- Stocker des données structurées (comme les informations d'un joueur : nom, score, niveau).
- Compter des occurrences (par exemple, combien de fois chaque mot apparaît dans un texte).
- Regrouper des données associées (comme associer chaque héros à son score).
Paires clé-valeur, défini avec des accolades {}.
| Opération | Syntaxe | Description |
|---|---|---|
| Créer | experience = {"nom": "Électrolyse", "tentative": 2} | Nouveau dictionnaire |
| Créer (vide) | experience = {} | Dictionnaire vide |
| Accéder | valeur = experience["nom"] | Valeur associée à la clé |
| Ajouter / Modifier | experience["succes"] = True | Ajoute ou écrase la paire clé-valeur |
| Supprimer | del experience["tentative"] | Supprime la paire clé-valeur |
| Présence | cle_existe = "nom" in experience | Vérifie si la clé existe |
| Clés | liste_cles = experience.keys() | Retourne toutes les clés |
| Valeurs | liste_valeurs = experience.values() | Retourne toutes les valeurs |
| Paires | liste_paires = experience.items() | Retourne les paires (clé, valeur) |
| Longueur | nb_paires = len(experience) | Nombre de paires clé-valeur |
| Itérer (clés) | for cle in experience.keys(): | Parcourir toutes les clés |
| Itérer (valeurs) | for val in experience.values(): | Parcourir toutes les valeurs |
| Itérer (paires) | for cle, val in experience.items(): | Parcourir clés et valeurs |
Les explications de cette section étaient-elles claires ?
Matplotlib est une bibliothèque de visualisation de données en Python qui permet de créer des graphiques statiques, animés et interactifs. Elle est largement utilisée pour l'analyse de données, la science des données et l'apprentissage-machine (machine learning).
N'hésitez pas à consulter la documentation officielle de Matplotlib pour plus de détails et d'exemples.
Afin de pouvoir utiliser Matplotlib dans un projet, il faut d'abord installer la bibliothèque Matplotlib dans votre projet.
Matplotlib est une bibliothèque qui contient plusieurs modules.
Le module le plus couramment utilisé pour créer des graphiques est pyplot.
Pour l'importer dans un script, on utilise la commande suivante :
import matplotlib.pyplot as plt
Ici, nous importons le module pyplot de Matplotlib et lui donnons l'alias plt pour simplifier son utilisation dans le code.
Nous pourrons ainsi appeler les fonctions du module pyplot en utilisant le préfixe plt.
Par exemple :
plt.plot(x, y)  # Pour tracer un graphique
plt.show()      # Pour afficher le graphique
qui est plus court et lisible que :
matplotlib.pyplot.plot(x, y)
matplotlib.pyplot.show()
Créons d'abord un graphique très simple, avec 3 points :
import matplotlib.pyplot as plt

# Données à tracer
x = [-100, 0, 100]     # Liste des abscisses (x) des 3 points
y = [10000, 0, 10000]  # Liste des ordonnées (y) des 3 points

# Tracer les points (-100, 10000), (0, 0) et (100, 10000)
plt.plot(x, y)

# Afficher le graphique
plt.show()
Exécutez ce code pour voir le résultat.
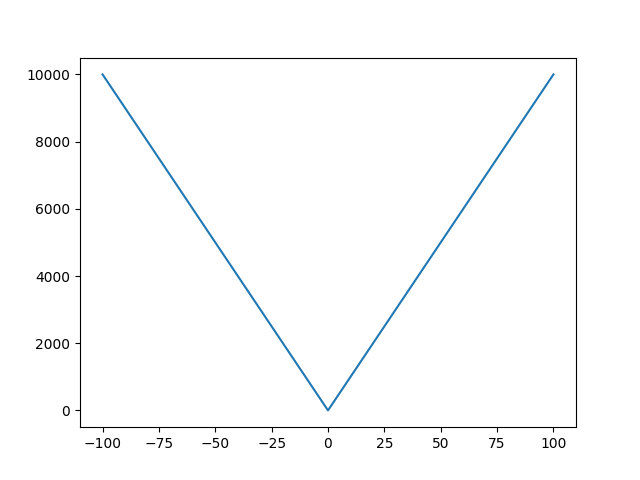
⏸️ Avec plt.show(), le graphique s'ouvre dans une fenêtre et le programme reste en pause jusqu'à ce que vous fermiez la fenêtre.
Si votre programme « ne finit pas », vérifiez qu'aucune fenêtre de graphique n'est restée ouverte!
La fonction plt.plot(x, y) trace les points définis par les listes x et y.
Elle nécessite qu'on lui fournisse deux listes de même longueur : une pour les abscisses (x) et une pour les ordonnées (y).
❌ Si les deux listes n'ont pas la même longueur, par exemple x = [-100, 0, 100] et y = [10000, 0] :
ValueError: x and y must have same first dimension, but have shapes (3,) and (2,)
Les shapes (3,) et (2,) indiquent la longueur de chaque liste : il manque une valeur dans y!
Mais elle peut aussi prendre des paramètres optionnels pour personnaliser le graphique, comme la couleur, le style de ligne, les marqueurs, etc.
Nous allons en voir quelques-uns. Commençons par leurs valeurs par défaut :
import matplotlib.pyplot as plt

# Données à tracer
x = [-100, 0, 100]
y = [10000, 0, 10000]

# Tracer les points
plt.plot(
    x, y,
    color = 'C0',     # couleur
    linestyle = '-',  # type de ligne
    marker = None,    # type de point
    linewidth = 1.5,  # épaisseur de la ligne
    markersize = 6,   # taille des marqueurs
    alpha = 1.0,      # opacité (0.0 - 1.0)
    label = None      # étiquette pour la légende
)

plt.show()
Le résultat est le même qu'avec plt.plot(x, y), car les paramètres que nous avons spécifiés sont les valeurs par défaut.
Il n'est pas nécessaire d'écrire tous les paramètres d'une fonction!
On commence par appeler la fonction avec seulement ses paramètres obligatoires.
Une fois que le graphique de base s'affiche correctement, on ajoute les paramètres facultatifs un à la fois, en vérifiant le résultat à chaque ajout.
La plupart des exercices ne demandent d'ailleurs que quelques paramètres.
plt.plot(x, y):xetysont les seuls paramètres obligatoires.color,linestyle,label, etc. sont facultatifs.plt.legend(): aucun paramètre obligatoire.
Exemple de progression :
# Étape 1 : version minimale, seulement les paramètres obligatoires
plt.plot(x, y)

# Étape 2 : on ajoute un paramètre facultatif et on vérifie le résultat
plt.plot(x, y, color='green')

# Étape 3 : on en ajoute un autre, puis on affiche la légende
plt.plot(x, y, color='green', label='y = x²')
plt.legend()
Si une erreur apparaît, on sait qu'elle vient du dernier paramètre ajouté.
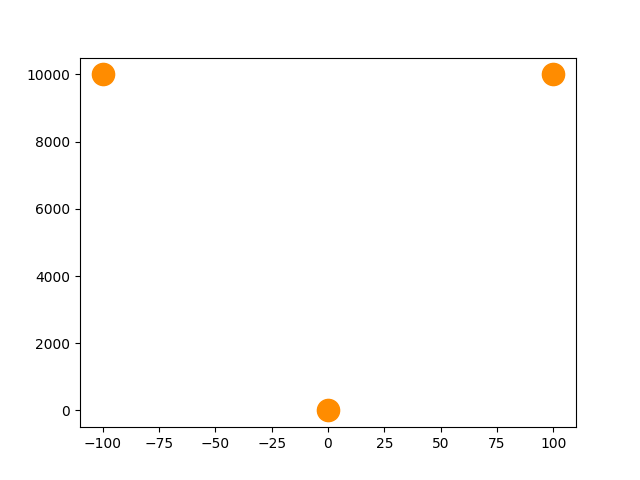
Changeons quelques paramètres pour voir leur effet :
import matplotlib.pyplot as plt

x = [-100, 0, 100]
y = [10000, 0, 10000]

plt.plot(
    x, y,
    color = 'darkorange',  # orange foncé
    linestyle = '',        # pas de ligne
    marker = 'o',          # cercle pour les points
    markersize = 16        # points plus gros
)

plt.show()
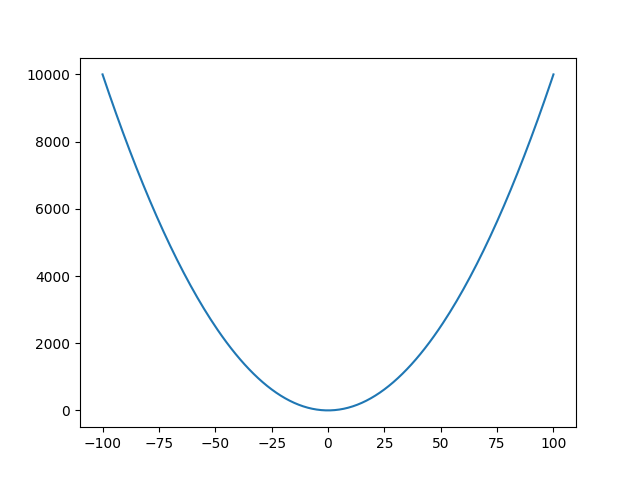
Ajoutons maintenant plus de points pour obtenir une courbe de :
import matplotlib.pyplot as plt

# Données à tracer
x = [i for i in range(-100, 101)]  # Entiers de -100 à 100
y = [i ** 2 for i in x]            # Carrés des entiers

plt.plot(x, y)

plt.show()
On obtient une belle parabole.
On peut appeler plusieurs fois plt.plot() pour ajouter plusieurs éléments sur le même graphique.
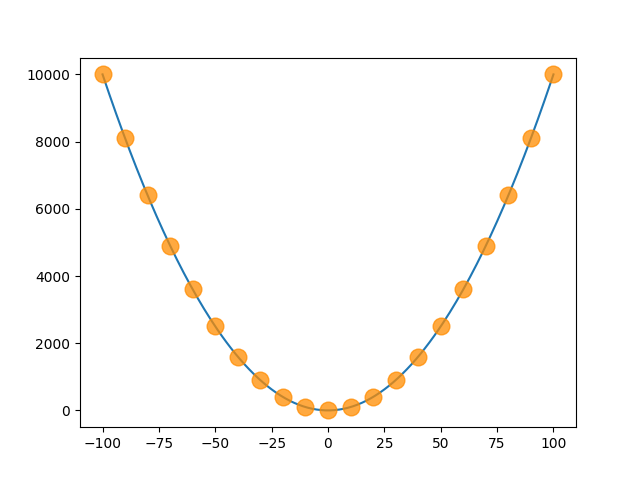
Par exemple, affichons en orange foncé les points où x est un multiple de 10 :
- Le premier appel à
plt.plot()dessine les lignes. - Puis un deuxième appel à
plt.plot()dessine les points en orange avec une opacité de 0.75.
import matplotlib.pyplot as plt

x = [i for i in range(-100, 101)]
y = [i ** 2 for i in x]

# Points oranges pour les x multiples de 10
x_orange = [i for i in x if i % 10 == 0]
y_orange = [i ** 2 for i in x_orange]

# les lignes :
plt.plot(x, y)

# les points :
plt.plot(
    x_orange, y_orange,
    color = 'darkorange',
    linestyle = '',        # pas de ligne
    marker = 'o',
    markersize = 12,
    alpha = 0.75
)

plt.show()
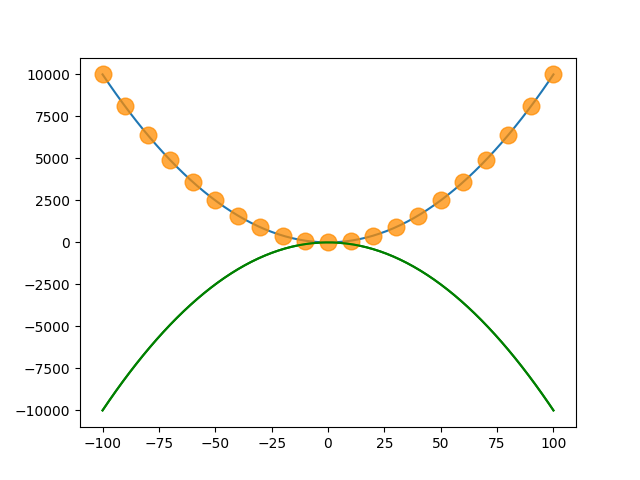
Ajoutons maintenant la courbe miroir en vert pour :
import matplotlib.pyplot as plt

x = [i for i in range(-100, 101)]
y = [i ** 2 for i in x]
y_miroir = [-i for i in y]  # miroir de y

x_orange = [i for i in x if i % 10 == 0]
y_orange = [i ** 2 for i in x_orange]

plt.plot(x, y)
plt.plot(
    x_orange, y_orange,
    color = 'darkorange',
    linestyle = '',
    marker = 'o',
    markersize = 12,
    alpha = 0.75
)
plt.plot(
    x, y_miroir,
    color = 'green'
)

plt.show()
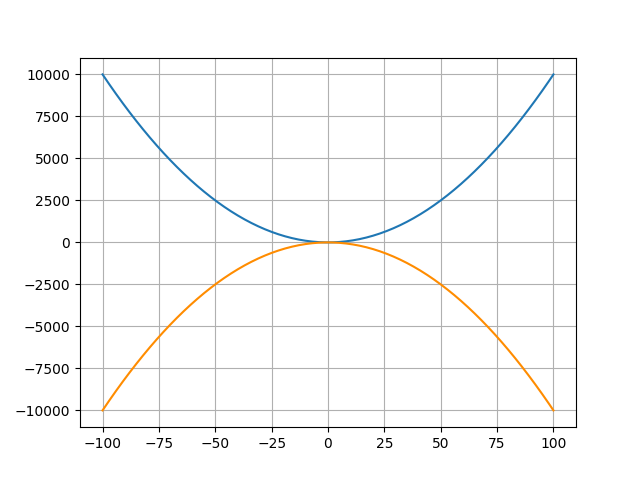
On peut ajouter une grille pour mieux visualiser les points, à l'aide de la fonction plt.grid() :
import matplotlib.pyplot as plt

x = [i for i in range(-100, 101)]
y = [i ** 2 for i in x]
y_miroir = [-i for i in y]

plt.plot(x, y)
plt.plot(x, y_miroir, color = 'darkorange')

# Ajouter une grille (valeurs par défaut)
plt.grid(
    axis = 'both',      # 'both' : les 2 axes
                        # 'x' : lignes verticales
                        # 'y' : lignes horizontales
    linestyle = '-',    # ligne pleine
    linewidth = 0.8,    # épaisseur fine
    color = '#b0b0b0',  # gris pâle
    alpha = 1.0         # opaque
)
# Si la grille passe par-dessus des points, ajouter :
plt.gca().set_axisbelow(True)

plt.show()
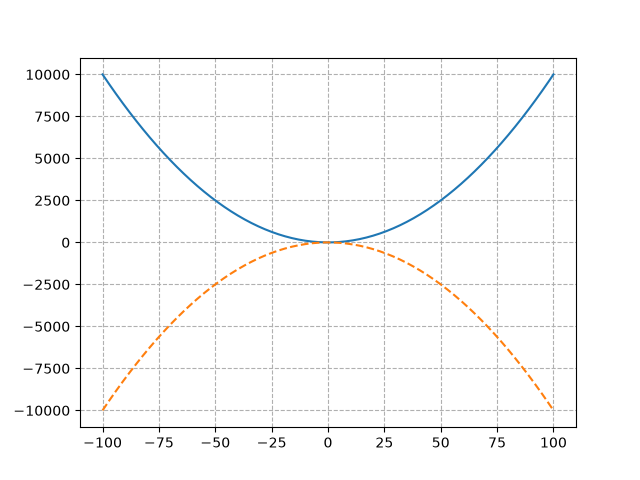
Le paramètre facultatif linestyle permet de changer le style de ligne, autant pour une courbe (plt.plot()) que pour la grille (plt.grid()).
Par exemple, linestyle='--' trace une ligne pointillée :
import matplotlib.pyplot as plt

x = [i for i in range(-100, 101)]
y = [i ** 2 for i in x]
y_miroir = [-i for i in y]

plt.plot(x, y)
plt.plot(x, y_miroir, linestyle='--')  # courbe pointillée

plt.grid(linestyle='--')  # grille pointillée
plt.gca().set_axisbelow(True)

plt.show()
Remarquez qu'on n'a pas indiqué de couleur, mais que les deux courbes sont quand même de couleurs différentes (bleu et orange). Quand on trace plusieurs courbes, Matplotlib leur donne automatiquement des couleurs différentes.
Le paramètre color n'est donc nécessaire que pour choisir une couleur précise.
Pour rendre le graphique plus compréhensible, on peut ajouter un titre au graphique, des étiquettes (labels) aux axes et on peut aussi personnaliser les ticks (valeurs affichées) d'un axe, en modifiant leur rotation, leur alignement et la taille de leur police :
import matplotlib.pyplot as plt

x = [i for i in range(-100, 101)]
y = [i ** 2 for i in x]
y_miroir = [-i for i in y]

plt.plot(x, y)
plt.plot(x, y_miroir, color = 'darkorange')

# Titre du graphique
plt.title("Graphique de y = x² et y = -x²")

# Titres des axes
plt.xlabel("Axe des X")
plt.ylabel("Axe des Y")

# Personnalisation des ticks
# (valeurs affichées) de l'axe des X
plt.xticks(
    rotation=30, # rotation des ticks
    ha='right',  # alignement horizontal
    fontsize=20  # taille de la police
)

# Ajuste la mise en page pour éviter les coupures
plt.tight_layout()

plt.show()
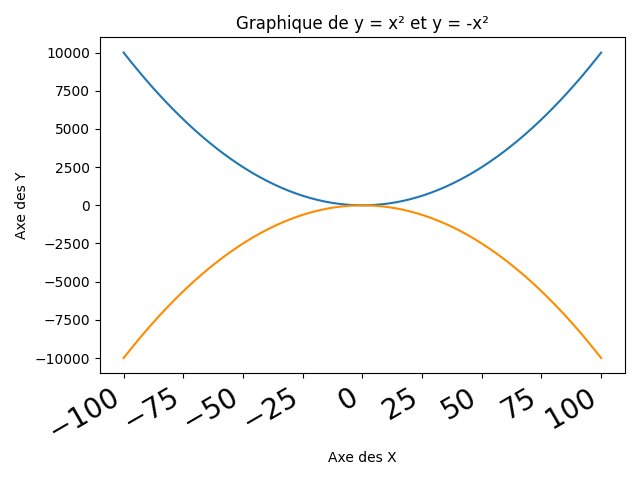
Lorsque nous avons plusieurs courbes sur le même graphique, il est important de les différencier en ajoutant une légende.
Pour cela, on peut utiliser le paramètre label dans les appels à plt.plot() pour donner une étiquette à chaque courbe, puis appeler la fonction plt.legend() pour afficher la légende avec les étiquettes correspondantes :
import matplotlib.pyplot as plt

x = [i for i in range(-100, 101)]
y = [i ** 2 for i in x]
y_miroir = [-i for i in y]

plt.plot(
    x, y,
    label='y = x²'  # étiquette pour la légende
)
plt.plot(
    x, y_miroir,
    marker='o',
    color = 'darkorange',
    label='y = -x²' # étiquette pour la légende
)

# Affiche la légende avec les
# étiquettes définies dans les appels à plt.plot()
plt.legend(
    loc='lower right', # position
    title="Fonction",  # titre de la légende
    title_fontsize=30, # taille du titre
    prop={'size': 20}, # taille des étiquettes
    markerscale=2      # taille des marqueurs
)

plt.show()
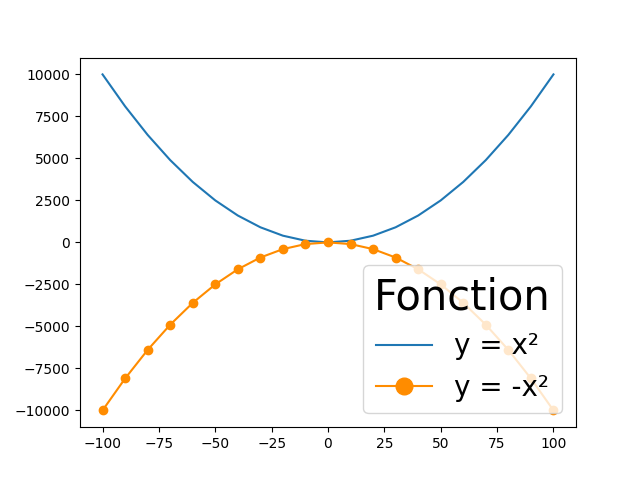
plt.legend() sans labelplt.legend() affiche seulement les étiquettes données avec le paramètre label="..." dans les appels à plt.plot().
Si aucune courbe n'a de label, la légende n'affiche rien (Matplotlib affiche seulement un avertissement dans la console).
plt.plot(x, y)
plt.plot(x, y_miroir)
plt.legend()                       # ❌ aucune légende : les courbes n'ont pas de label
plt.plot(x, y, label='y = x²')
plt.plot(x, y_miroir, label='y = -x²')
plt.legend()                       # ✅ la légende affiche « y = x² » et « y = -x² »
Si on souhaite décider de la taille exacte de notre graphique, on peut utiliser la fonction plt.figure(), qui doit être appelée avant les appels à plt.plot() :
import matplotlib.pyplot as plt

x = [i for i in range(-100, 101)]
y = [i ** 2 for i in x]
y_miroir = [-i for i in y]

# largeur = 9 pouces, hauteur = 4 pouces
plt.figure(figsize=(9, 4))

plt.plot(x, y)
plt.plot(x, y_miroir, color = 'darkorange')

plt.show()
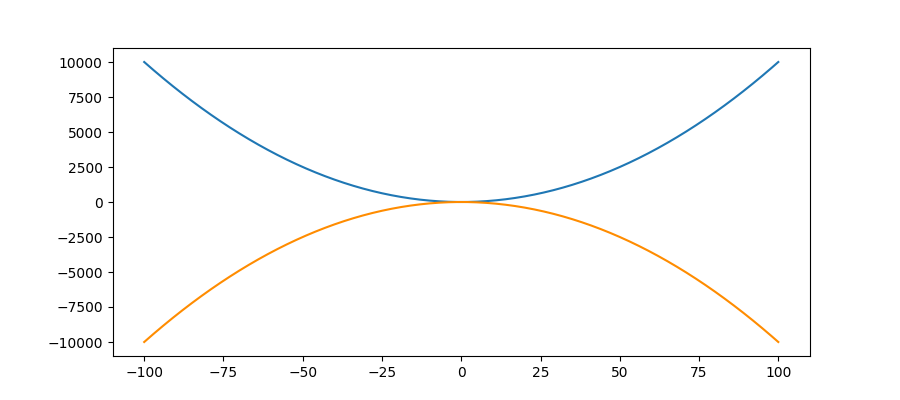
Au lieu d'afficher le graphique à l'écran avec plt.show(), on peut le sauvegarder dans un fichier image (PNG, JPG, SVG, etc.) en utilisant la fonction plt.savefig() :
plt.savefig("mon_graphique.png")  # Sauvegarde le graphique en format PNG
plt.savefig("mon_graphique.svg")  # Sauvegarde le graphique en format SVG
plt.savefig("mon_graphique.jpg")  # Sauvegarde le graphique en format JPG
plt.savefig("mon_graphique.pdf")  # Sauvegarde le graphique en format PDF
Il faut ajouter ce code avant plt.show(), et un fichier image sera créé dans le même répertoire que le script, avec le nom spécifié.
Lorsqu'on génère plusieurs graphiques dans le même script, il est important de les gérer correctement pour éviter les confusions entre les différentes figures.
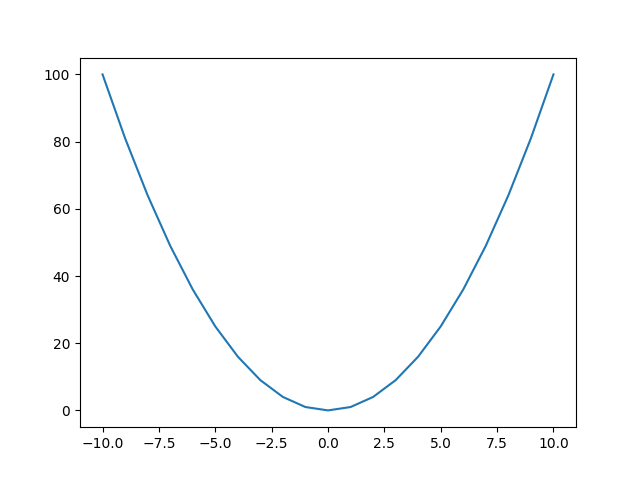
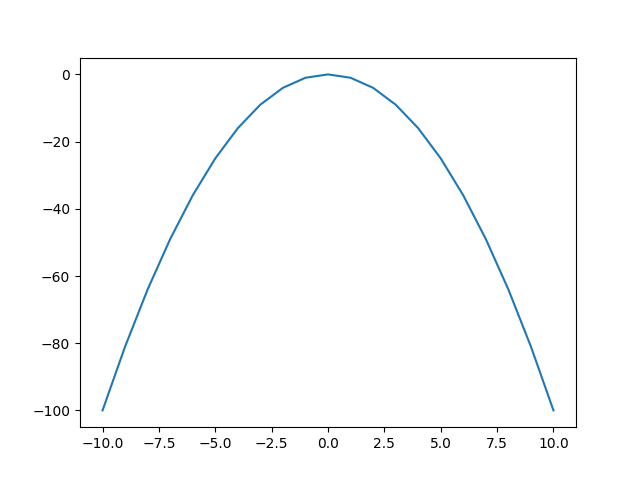
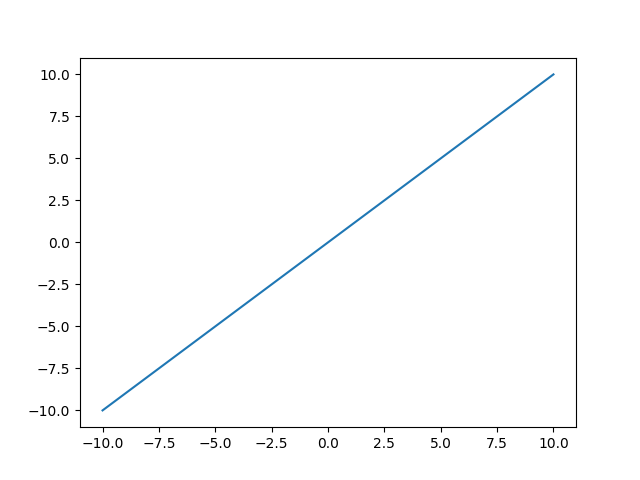
Ce code génère 3 courbes différentes sur le même graphique :
import matplotlib.pyplot as plt

x = [i for i in range(-10, 11)]
y = [i ** 2 for i in x]

plt.plot(x, y)
plt.plot(x, [-i for i in y])
plt.plot(x, x)

plt.savefig("figure.pdf")
plt.show()
Remarque : par défaut, chaque appel à plt.plot() utilise une couleur différente, ce qui permet de différencier les courbes.
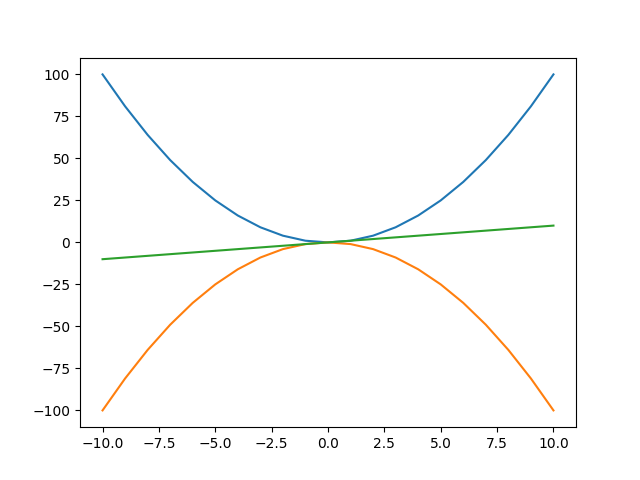
Mais si on voulait créer plusieurs graphiques séparés, il faut utiliser plt.figure() pour créer une nouvelle figure avant de tracer un nouveau graphique :
import matplotlib.pyplot as plt

x = [i for i in range(-10, 11)]
y = [i ** 2 for i in x]

plt.figure()                # Crée une première figure
plt.plot(x, y)              # Trace une courbe dans cette première figure
plt.savefig("figure1.pdf")  # Sauvegarde la figure

plt.figure()                # Crée une nouvelle figure
plt.plot(x, [-i for i in y])
plt.savefig("figure2.pdf")

plt.figure()
plt.plot(x, x)
plt.savefig("figure3.pdf")

plt.show()                  # Affiche toutes les figures
- L’appel à
plt.show()est optionnel et sert uniquement à afficher les figures à l’écran. - Sans
plt.figure(), les courbes seraient toutes tracées sur la même figure.
Matplotlib offre une grande variété de types de graphiques pour visualiser les données de différentes manières.
Vous pouvez les explorer dans la documentation officielle de Matplotlib.
Voici quelques exemples qui vous seront utiles :
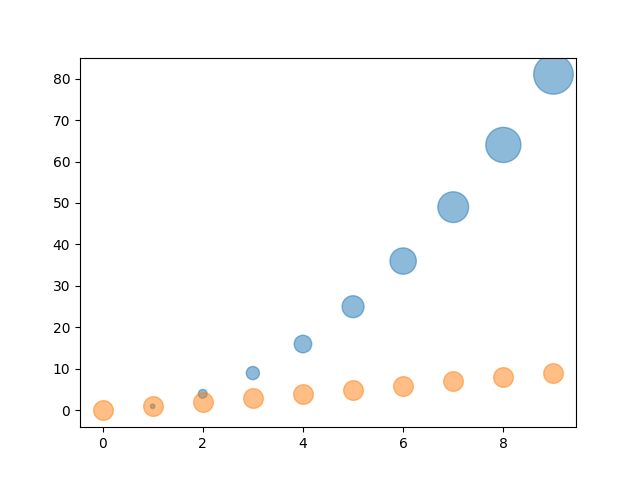
plt.scatter() : pour créer des nuages de points
import matplotlib.pyplot as plt

x = [i for i in range(10)]
y = [i ** 2 for i in x]

tailles_points = [i * 10 for i in y]
# [0, 10, 40, 90, 160, 250, 360, 490, 640, 810]

plt.scatter(x, y, alpha=0.5, s=tailles_points)
plt.scatter(x, x, alpha=0.5, s=200)

plt.show()
plt.scatter() permet de dessiner des points, tout comme plt.plot() avec marker='o' et linestyle=''.
Cependant, plt.scatter() offre plus de contrôle, notamment en permettant de modifier la taille (s) de chaque point individuellement (ici les points bleus).
plt.bar() : pour créer des graphiques à barres
import matplotlib.pyplot as plt

categories = ['A', 'B', 'C', 'D']
valeurs = [10, 15, 7, 12]

plt.bar(categories, valeurs)

plt.show()

Le paramètre facultatif color permet de choisir la couleur des barres.
Si on lui donne une liste de couleurs, chaque barre reçoit la couleur à la même position dans la liste (la 1re barre reçoit la 1re couleur, etc.) :
import matplotlib.pyplot as plt

categories = ['A', 'B', 'C', 'D']
valeurs = [10, 15, 7, 12]
couleurs = ['skyblue', 'limegreen', 'gold', 'salmon']

plt.bar(categories, valeurs, color=couleurs)

plt.show()
La liste couleurs doit contenir autant d'éléments que la liste categories.
Pour que toutes les barres aient la même couleur, on donne une seule couleur : color='skyblue'.

plt.boxplot() : pour créer des boîtes à moustaches
Contrairement à plt.bar(), qui affiche une seule valeur par catégorie, plt.boxplot() permet de visualiser la distribution complète des données pour chaque catégorie.
import matplotlib.pyplot as plt

categories = ['A', 'B', 'C', 'D']
data = [
    [1, 2, 3, 4, 5],
    [2, 3, 4, 5, 6],
    [1, 3, 5, 7, 9],
    [2, 2, 3, 3, 4, 10]
]

plt.boxplot(data, tick_labels=categories)

plt.show()

Comment interpréter une boîte à moustaches :
- La ligne du milieu (orange) représente la médiane : 50 % des valeurs sont en dessous, 50 % au-dessus.
- Le bas de la boîte représente le 1er quartile (Q1) : 25 % des valeurs sont en dessous.
- Le haut de la boîte représente le 3e quartile (Q3) : 75 % des valeurs sont en dessous.
- La hauteur de la boîte est l’intervalle interquartile (IQR) = Q3 − Q1 : il contient le 50 % central des données.
- Les moustaches (les traits) s’étendent jusqu’à 1,5 × IQR au-delà de Q1 et Q3.
- Les cercles (•) sont les valeurs aberrantes (outliers) : valeurs qui dépassent les moustaches.
Voici les problèmes les plus fréquents : certains génèrent une erreur explicite, d'autres produisent silencieusement un résultat inattendu.
Avant de chercher l'erreur à la main, on utilise le débogueur PyCharm.
On place un point d'arrêt avant plt.plot() et on inspecte les listes dans le panneau des variables :
- on vérifie leur longueur avec
len() - on vérifie leur type avec
type() - on vérifie leurs valeurs
Le débogueur montre exactement ce que Matplotlib reçoit comme données.
ValueError: x and y must have same first dimensionLes listes x et y n'ont pas le même nombre d'éléments. On vérifie que leurs longueurs sont identiques.
ValueError: x and y must have same first dimension, but have shapes (3,) and (2,)
x = [1, 2, 3]
y = [10, 20]       # ❌ 2 éléments au lieu de 3
plt.plot(x, y)     # → ValueError
x = [1, 2, 3]
y = [10, 20, 30]   # ✅ même nombre d'éléments
plt.plot(x, y)
On a oublié plt.show(), ou on a appelé plt.show() avant de tracer les données. plt.show() doit toujours venir en dernier.
plt.show()         # ❌ avant de tracer
plt.plot(x, y)
plt.plot(x, y)

plt.show()         # ✅ en dernier
Matplotlib réutilise la même figure par défaut. Il faut appeler plt.figure() avant de commencer un nouveau graphique pour repartir d'une ardoise vide.
plt.plot(x, y1)
plt.show()

plt.plot(x, y2)    # ❌ s'ajoute à la figure précédente
plt.show()
plt.figure()       # ✅ nouvelle figure vide
plt.plot(x, y1)

plt.figure()       # ✅ nouvelle figure vide
plt.plot(x, y2)

plt.show()         # ✅ affiche les deux figures séparément
AttributeError: ... got an unexpected keyword argumentLe nom d'un paramètre facultatif est mal écrit. « unexpected keyword argument » signifie que Matplotlib ne connaît aucun paramètre portant ce nom.
On vérifie l'orthographe et les majuscules : Python distingue les majuscules des minuscules, donc Linestyle et linestyle sont deux noms différents.
AttributeError: Line2D.set() got an unexpected keyword argument 'Linestyle'
plt.plot(x, y, Linestyle='--') # ❌ « L » majuscule → AttributeError
plt.plot(x, y, linestyle='--') # ✅ tout en minuscules
Le message indique entre apostrophes le nom fautif ('Linestyle') : c'est ce paramètre qu'il faut corriger.
Les explications de cette section étaient-elles claires ?
Pour favoriser une progression efficace, ce cours adopte une approche de classe inversée. Ce modèle déplace l'acquisition théorique hors de la classe pour transformer les heures de rencontre en véritables séances d'application pratique.
-
À la maison (Exploration et Appropriation) : Vous êtes le maître de votre rythme. Ces activités vous permettent de découvrir les nouveaux concepts et tester les exemples au moment où vous êtes le plus concentré. Si une notion vous semble obscure, n'hésitez pas à poser des questions à votre prof au fur et à mesure.
-
En classe (Application et Consolidation) : Le temps en présentiel est une ressource précieuse. Nous l'utilisons pour nous attaquer aux défis plus complexes et aux exercices de programmation qui demandent une mobilisation active de vos connaissances. C’est le moment idéal pour obtenir une rétroaction immédiate, collaborer avec vos pairs et bénéficier de l'accompagnement de votre enseignant au moment où vous en avez le plus besoin.
- 🏠 Activités à faire à la maison
- 🏫 Activités à faire en classe
🧠 Auto-validation des connaissances
Ce formulaire sert à vérifier votre compréhension des éléments les plus importants de la rencontre R09. Ne faites ce questionnaire que lorsque vous vous sentez en très bonne maîtrise de la matière. En classe, dès votre arrivée, vous aurez un questionnaire très similaire, évalué sommativement, à compléter sans accès à aucune documentation.
Ne pas remplir le formulaire diminue fortement vos chances de réussir l’évaluation sommative en début de rencontre.
Assurez-vous de bien comprendre toutes les notions derrière chaque question.
🔨 Exercices de création
Pour chacun des exercices de cette section, vous devez créer des fichiers .py avec les noms indiqués.
Pour les exercices de cette section, vous pouvez consulter librement la documentation du site web du cours.
📁 Créez un fichier r09_virus_liste_simple.py pour votre réponse.
Umbrella Corporation souhaite afficher la liste des virus qu'elle possède.
La présentation souhaitée est détaillée ci-dessous. La liste est contenue dans la variable virus.
virus = ["Virus-T", "Virus-C", "Virus-G", "Uroboros"]
⚠️ CONTRAINTES À RESPECTER
- Votre code doit fonctionner peu importe le nombre d'éléments dans la liste.
- Si la liste est vide, afficher un message sympa à l'utilisateur.
- Si la liste n'est pas vide, vous devez utiliser un
for element in listepour parcourir les éléments de la liste. - Vous pouvez modifier le contenu de la liste fournie pour tester différents scénarios.
✅ RÉSULTAT ATTENDU AVEC LA LISTE DE DÉPART FOURNIE
Liste des 4 virus :
    Virus-T
    Virus-C
    Virus-G
    Uroboros
✅ RÉSULTAT ATTENDU AVEC UNE LISTE À 2 ÉLÉMENTS
Liste des 2 virus :
    Virus-T
    Virus-C
✅ RÉSULTAT ATTENDU AVEC UNE LISTE VIDE
Désolé aucun produit pharmaceutique mortel disponible
Listes, boucle for ... in, fonction len(), test de liste vide
📁 Créez un fichier r09_virus_listes_paralleles.py pour votre réponse.
Recopiez le code de l'exercice précédent, il vous servira de point de départ.
La Umbrella Corporation souhaite améliorer le rapport précédent fait.
Elle vous fournit sous la forme d'une liste des caractéristiques sur chaque virus.
virus = ["Virus-T", "Virus-C", "Virus-G", "Uroboros"]
caracteristiques = [
    "Transforme les humains en zombies et armes biologiques",
    "Provoque des mutations extrêmes et régénère les tissus",
    "Cause des mutations incontrôlables avec régénération cellulaire rapide",
    "Consomme les organismes incompatibles et renforce les hôtes compatibles"
]
Comme les deux listes doivent être parcourues en parallèle via un index commun, un for element in liste ne fonctionnera pas. Utilisez for i in range(len()).
✅ RÉSULTAT ATTENDU AVEC LES LISTES DE DÉPART FOURNIES
Liste des 4 virus :
    Virus-T - Transforme les humains en zombies et armes biologiques
    Virus-C - Provoque des mutations extrêmes et régénère les tissus
    Virus-G - Cause des mutations incontrôlables avec régénération cellulaire rapide
    Uroboros - Consomme les organismes incompatibles et renforce les hôtes compatibles
✅ RÉSULTAT ATTENDU AVEC DES LISTES À 2 ÉLÉMENTS
Liste des 2 virus :
    Virus-T - Transforme les humains en zombies et armes biologiques
    Virus-C - Provoque des mutations extrêmes et régénère les tissus
Listes parallèles, boucle for i in range(len(...)), parcours par index
📁 Créez un fichier r09_virus_liste_2d.py pour votre réponse.
Recopiez le code du premier exercice, il vous servira de point de départ.
La Umbrella Corporation souhaite améliorer le rapport précédent fait.
La corporation souhaite désormais afficher dans le rapport le taux de succès de mutation.
Elle vous fournit désormais toutes les données sous la forme d'une seule liste!
virus_et_autres_info = [
    ["Virus-T", 0.9 ,"Transforme les humains en zombies et armes biologiques"],
    ["Virus-C", 0.0001 ,"Provoque des mutations extrêmes et régénère les tissus"],
    ["Virus-G", 0.85, "Cause des mutations incontrôlables avec régénération cellulaire rapide"],
    ["Uroboros", 0.005, "Consomme les organismes incompatibles et renforce les hôtes compatibles"]
]
Le taux de mutation est stocké comme un nombre décimal (ex. 0.9). Pour l'afficher en pourcentage, multipliez par 100 (ex. 0.9 * 100 = 90.0%).
✅ RÉSULTAT ATTENDU AVEC LA LISTE DE DÉPART FOURNIE
Liste des 4 virus :
    Virus-T - Transforme les humains en zombies et armes biologiques (taux de mutation estimé : 90.0%)
    Virus-C - Provoque des mutations extrêmes et régénère les tissus (taux de mutation estimé : 0.01%)
    Virus-G - Cause des mutations incontrôlables avec régénération cellulaire rapide (taux de mutation estimé : 85.0%)
    Uroboros - Consomme les organismes incompatibles et renforce les hôtes compatibles (taux de mutation estimé : 0.5%)
✅ RÉSULTAT ATTENDU AVEC UNE LISTE DE 2 LISTES
Liste des 2 virus :
    Virus-T - Transforme les humains en zombies et armes biologiques (taux de mutation estimé : 90.0%)
    Virus-C - Provoque des mutations extrêmes et régénère les tissus (taux de mutation estimé : 0.01%)
Listes à 2 dimensions (listes imbriquées), accès par index multiple, f-strings, formatage de pourcentage
📁 Créez un fichier r09_comprehension_liste.py pour votre réponse.
La compréhension de liste permet de transformer, filtrer et manipuler des données de manière concise et efficace.
À partir de la liste suivante :
liste = [1, 2, 3, 4, 5]
Vous devez créer 6 nouvelles listes en utilisant exclusivement la compréhension de liste.
Chaque cas représente une transformation ou une opération différente.
🧩 CAS À COMPLÉTER
-
Multiplier chaque élément par 5
Résultat attendu : [5, 10, 15, 20, 25] -
Garder uniquement les nombres supérieurs à 2
Résultat attendu : [3, 4, 5] -
Créer une liste de booléens indiquant si chaque nombre est supérieur à 3
Résultat attendu : [False, False, False, True, True] -
Créer une nouvelle liste contenant les carrés sous forme de texte
Résultat attendu : ['Le carré de 1 est 1', 'Le carré de 2 est 4', ..., 'Le carré de 5 est 25']
Une f-string sera nécessaire dans la section expression de la compréhension de liste.
- Remplacer les nombres impairs par le mot "impair"
Résultat attendu : ['impair', 2, 'impair', 4, 'impair']
Un if/else compacte est nécessaire dans la section expression de la compréhension de liste.
- Doubler uniquement les nombres pairs
Résultat attendu : [4, 8]
✅ FORMAT ATTENDU
Pour chaque cas, vous devez écrire votre code comme ceci :
casX = [ ... ]  # Remplacez les "..." par votre compréhension de liste
print(casX)
Compréhension de liste, filtrage (if), transformation (expression), if/else compact, f-strings
📁 Créez un fichier r09_ensembles.py pour votre réponse.
Les ensembles (set) permettent de stocker des éléments uniques et d'effectuer des opérations mathématiques comme l'union, l'intersection ou la différence.
À partir des ensembles suivants :
ensemble1 = {1, 2, 3, 4, 5}
ensemble2 = {4, 5, 6, 7, 8}
Vous devez créer 3 nouveaux ensembles et compléter 1 cas de conversion.
Pour les cas 1 à 3, utilisez les opérations ensemblistes (union, intersection et différence) pour obtenir les résultats demandés.
- Chaque résultat doit être obtenu par une seule opération entre
ensemble1etensemble2. - Vous devez déterminer quelle opération convient à chaque cas.
- Vous ne devez pas modifier les ensembles de départ ni construire les résultats élément par élément (avec
add(),remove(), etc.). - N'utilisez ni boucles ni compréhensions de liste.
Pour le cas 4, utilisez les conversions appropriées pour éliminer les doublons et obtenir une liste triée.
🧩 CAS À COMPLÉTER
- Résultat attendu : {1, 2, 3, 4, 5, 6, 7, 8}
- Résultat attendu : {4, 5}
- Résultat attendu : {1, 2, 3}
-
La liste suivante contient des doublons. Convertissez-la en ensemble pour les supprimer, puis obtenez une liste triée.
Résultat attendu : [1, 3, 5, 7, 9]mesures = [3, 7, 3, 1, 7, 9, 1, 5]
La fonction sorted() retourne une liste triée à partir d'un ensemble.
✅ FORMAT ATTENDU
Pour les cas 1 à 3, utilisez le format suivant :
casX = ensemble1 ... ensemble2  # Remplacez les "..." par l'opérateur approprié
print(casX)
Pour le cas 4 :
cas4 = ...  # Conversion et tri
print(cas4)
Ensembles (set), union, intersection, différence, conversion de types et tri avec sorted().
📁 Créez un fichier r09_dictionnaires_imbrique.py pour votre réponse.
Les données de température d'une journée d'une ville sont stockées sous forme de dictionnaire.
info = {
    "lieu": "Raccoon City",
    "date": "2025-07-12",
    "temperatures_C": {
        "Matin": 18.2,
        "Midi": 22.5,
        "Après-midi": 24.1,
        "Soir": 20.3
    }
}
Écrivez un programme qui :
- Affiche le lieu et la date en en-tête.
- Affiche chaque moment de la journée avec sa température, alignés en colonnes.
- Calcule et affiche la température moyenne.
Le résultat doit correspondre exactement au format suivant (y compris les espaces, les lignes vides et les indentations) :
Températures à Raccoon City le 2025-07-12

    Matin       : 18.2 °C
    Midi        : 22.5 °C
    Après-midi  : 24.1 °C
    Soir        : 20.3 °C

Température moyenne : 21.28 °C
Pour accéder aux températures, utilisez info['temperatures_C']. C'est lui-même un dictionnaire que vous pouvez parcourir avec .items().
Consultez l'aide-mémoire sur les f-strings pour les options de formatage permettant d'aligner du texte sur une largeur fixe.
Dictionnaires imbriqués, accès par clé, .items(), calcul de moyenne, alignement avec f-strings
📁 Créez un fichier r09_jeu_devinette_ameliore.py pour votre réponse.
Partez du code suivant (version de base du jeu de devinette) et améliorez-le afin d'insulter gentiment l'utilisateur s'il saisit un nombre déjà saisi.
Malgré sa stupidité, vous devez quand même lui indiquer si la bonne réponse est plus haute ou plus basse!
import random

nombre_secret = random.randint(1, 100)

while True:
    devine = int(input("Tente de trouver le nombre que j'ai en tête : "))

    if devine == nombre_secret: #Condition d'arrêt de la boucle
        break
    elif devine < nombre_secret: # Indication sur la direction, même si l'essai était répété
        print("Plus haut!\n")
    else:
        print("Plus bas!\n")

print("Bravo humain, tu as trouvé le nombre!")
⚠️ CONTRAINTES À RESPECTER
- Stockez tous les essais de l'utilisateur dans un ensemble.
- Utilisez l'opérateur
inpour vérifier si un essai a déjà été saisi.
✅ EXEMPLE DE RÉSULTAT ATTENDU
Rappel : le nombre est choisi aléatoirement par l'ordinateur à chaque partie.Tente de trouver le nombre que j'ai en tête : 50
Plus haut!
Tente de trouver le nombre que j'ai en tête : 95
Plus bas!
Tente de trouver le nombre que j'ai en tête : 92
Plus bas!
Tente de trouver le nombre que j'ai en tête : 50
Tu ne sembles pas être le pingouin glissant le plus loin...
Tu avais déjà essayé cette réponse...
Plus haut!
Tente de trouver le nombre que j'ai en tête : 89
Bravo humain, tu as trouvé le nombre!
Boucle while, ensembles (accumulation), opérateur in, module random
📁 Créez un fichier r09_graphique_courbe_simple.py pour votre réponse.
Vous devez reproduire, le plus fidèlement possible, le graphique suivant :
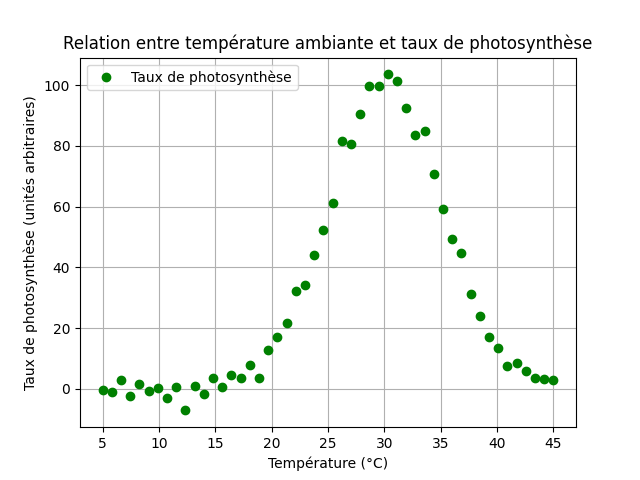
Les données nécessaires au graphique sont fournies sous la forme de 2 listes :
temperatures = [5.0, 5.816326530612245, 6.63265306122449, 7.448979591836735,
                8.26530612244898, 9.081632653061224, 9.89795918367347, 10.714285714285715,
                11.53061224489796, 12.346938775510203, 13.16326530612245, 13.979591836734695,
                14.795918367346939, 15.612244897959183, 16.42857142857143, 17.244897959183675,
                18.06122448979592, 18.877551020408163, 19.693877551020407, 20.510204081632654,
                21.3265306122449, 22.142857142857142, 22.95918367346939, 23.775510204081634,
                24.591836734693878, 25.408163265306122, 26.224489795918366, 27.040816326530614,
                27.857142857142858, 28.6734693877551, 29.48979591836735, 30.306122448979593,
                31.122448979591837, 31.93877551020408, 32.755102040816325, 33.57142857142857,
                34.38775510204081, 35.20408163265306, 36.02040816326531, 36.83673469387755,
                37.6530612244898, 38.46938775510204, 39.285714285714285, 40.10204081632653,
                40.91836734693878, 41.734693877551024, 42.55102040816327, 43.36734693877551,
                44.183673469387756, 45.0]

photosynthese = [-0.4208586207089154, -0.9002982388093212, 2.90695296113819, -2.3816678390159787,
                1.6301613438564548, -0.6395165673646073, 0.4062406047933971, -3.0807857229738986,
                0.7630986943366226, -7.109276797690082, 1.0400704458874834, -1.6231609563256293,
                3.5158201201035792, 0.7073045481852345, 4.462535684066591, 3.469725363276981,
                7.800055142339156, 3.6581720517708147, 12.848632806212834, 17.01723976662892,
                21.583172080660294, 32.30270168260925, 34.27508939188592, 43.959441989933595,
                52.391688150519585, 61.14262118477141, 81.52320747993383, 80.49707329499296,
                90.43305211916575, 99.87264809035379, 99.64218123860432, 103.57940043588764,
                101.38268425121551, 92.5592720723287, 83.62418715159393, 84.92142209312819,
                70.6148436983045, 59.1725221343123, 49.47349737546689, 44.62045689259768,
                31.310564654507512, 24.072064122012684, 16.917980484652784, 13.408756457014197,
                7.579626366114782, 8.420568754382284, 5.911835499055119, 3.4010226647009074,
                3.2056589365442028, 3.021178647669223]
Matplotlib, plt.plot(), courbe simple, titre et étiquettes d'axes
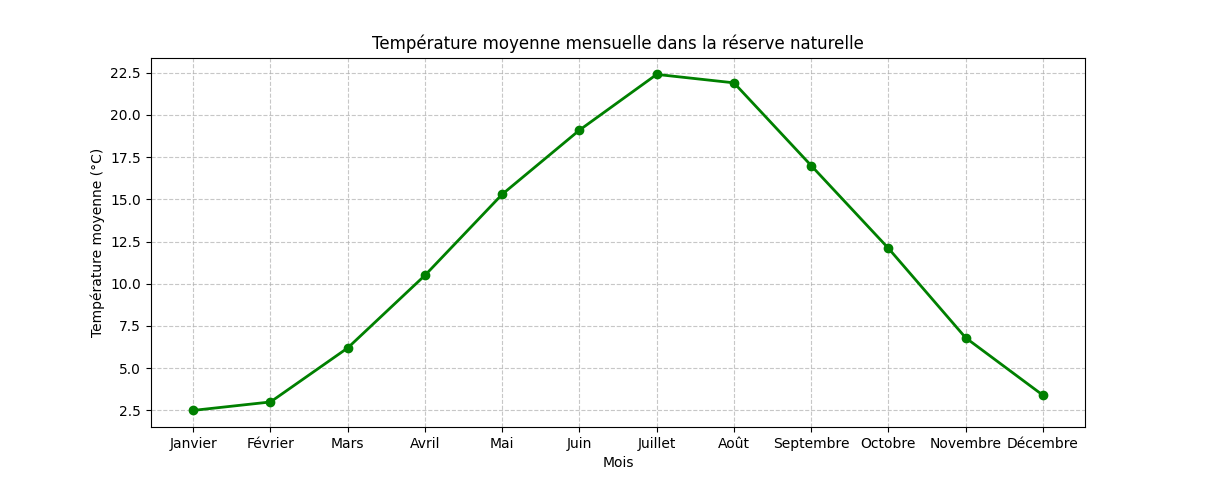
📁 Créez un fichier r09_graphique_temperatures_annuelles.py pour votre réponse.
Un chercheur suit la température moyenne enregistrée chaque mois dans une réserve naturelle.
Les données sont stockées sous forme d’une liste de tuples, où chaque tuple contient :
- le nom du mois
- la température moyenne en °C
Votre objectif :
- Extraire les noms des mois et les températures depuis la liste de tuples ci-dessous.
- Créer par programmation une liste pour les noms des mois et une liste pour les valeurs.
- La compréhension de liste peut vous aider à créer ces 2 listes rapidement.
- Afficher ces données dans un graphique linéaire pour visualiser l’évolution de la température au fil des mois.
- Ajouter un titre, une grille et des étiquettes d’axes claires en lien avec le graphique.
- Définissez les dimensions du graphique à 12x5 pouces en utilisant
plt.figure(...).- Cette instruction doit être placée avant toutes les autres instructions de traçage de votre graphique.
temperatures = [
    ("Janvier", 2.5),
    ("Février", 3.0),
    ("Mars", 6.2),
    ("Avril", 10.5),
    ("Mai", 15.3),
    ("Juin", 19.1),
    ("Juillet", 22.4),
    ("Août", 21.9),
    ("Septembre", 17.0),
    ("Octobre", 12.1),
    ("Novembre", 6.8),
    ("Décembre", 3.4)
]
Exemple de graphique attendu
Liste de tuples, compréhension de liste pour extraire des données, Matplotlib (graphique linéaire)
📁 Créez un fichier r09_graphique_barres_moyennes.py pour votre réponse.
Vous devez reproduire, le plus fidèlement possible, le graphique ci-dessous.
Il représente la consommation moyenne d’eau (millions de m3/an) au Canada.
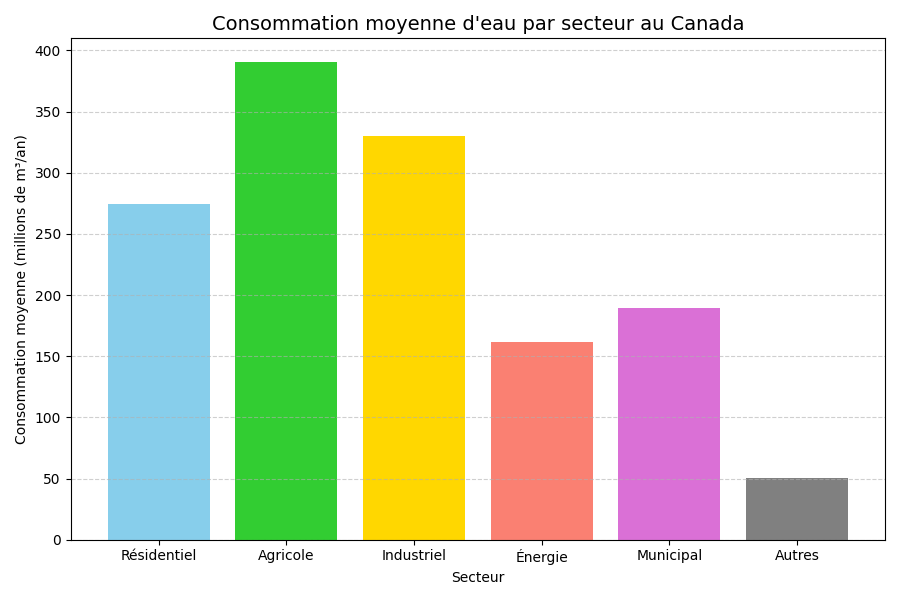
Vous devez créer une nouvelle liste représentant la moyenne pour chaque secteur.
Les données nécessaires au graphique sont fournies sous la forme des listes ci-dessous :
secteurs = ["Résidentiel", "Agricole", "Industriel", "Énergie", "Municipal", "Autres"]
couleur_barres = ["skyblue", "limegreen", "gold", "salmon", "orchid", "gray"]

# Données totales pour l’ensemble du Canada (12 données par liste, une donnée par province/territoire)
residentiel = [410, 380, 220, 200, 890, 860, 170, 180, 60, 100, 40, 30, 25]
agricole = [780, 640, 850, 600, 720, 670, 230, 210, 150, 180, 20, 15, 10]
industriel = [520, 410, 290, 310, 1100, 970, 190, 200, 50, 130, 60, 40, 20]
energie = [300, 270, 180, 150, 400, 420, 100, 110, 30, 90, 25, 20, 10]
municipal = [260, 250, 130, 120, 680, 700, 90, 100, 25, 70, 15, 10, 8]
autres = [90, 80, 60, 50, 130, 120, 40, 40, 10, 25, 5, 5, 3]
Calcul de moyennes sur des listes, Matplotlib plt.bar(), couleurs des barres, construction de nouvelles listes
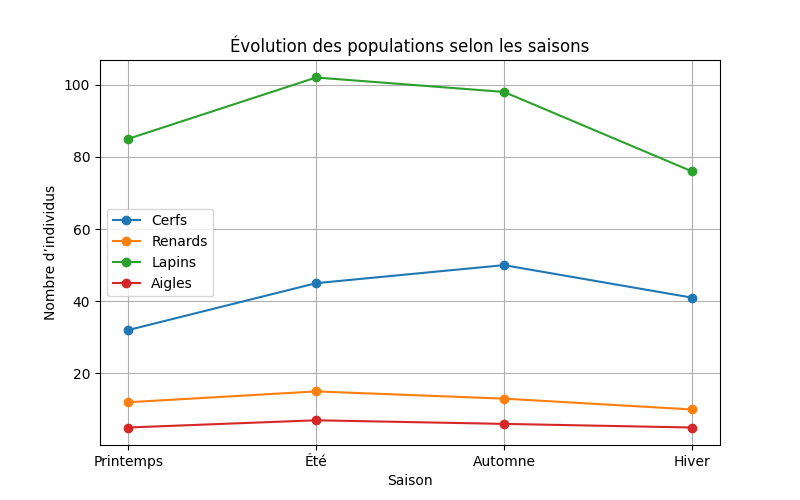
📁 Créez un fichier r09_graphique_populations_saison.py pour votre réponse.
Vous devez analyser les populations de différentes espèces animales dans une réserve naturelle.
Pour chaque espèce, une liste du nombre d’individus observés pour chacune des 4 saisons est fournie :
populations = {
    "Cerfs": [32, 45, 50, 41],
    "Renards": [12, 15, 13, 10],
    "Lapins": [85, 102, 98, 76],
    "Aigles": [5, 7, 6, 5]
}
saisons = ["Printemps", "Été", "Automne", "Hiver"]
ÉTAPE 1 - VOLET CONSOLE
Calculez et affichez à la console le résultat ci-dessous.
Les valeurs doivent être calculées à partir des données de la variable population.
Recensement pour les 4 espèces :

Cerfs : moyenne par saison = 42.0 individus
Renards : moyenne par saison = 12.5 individus
Lapins : moyenne par saison = 90.25 individus
Aigles : moyenne par saison = 5.75 individus
REMARQUES
- Votre code doit fonctionner peu importe le nombre d’animaux dans le dictionnaire
populations. - Les couleurs des courbes seront automatiquement les bonnes.
ÉTAPE 2 - VOLET GRAPHIQUE
Générez le graphique ci-dessous.
Dictionnaires, parcours avec .items(), calcul de moyenne, Matplotlib (courbes multiples), code générique
📁 Créez un fichier r09_graphique_nuage_courbe.py pour votre réponse.
Vous devez reproduire, le plus fidèlement possible, le graphique ci-dessous.
Il représente la croissance de 10 plantes sur 30 jours.
Chaque point en vert semi-transparent représente une mesure d’une plante, il y a donc 300 points.
La courbe représente la moyenne de leur croissance.
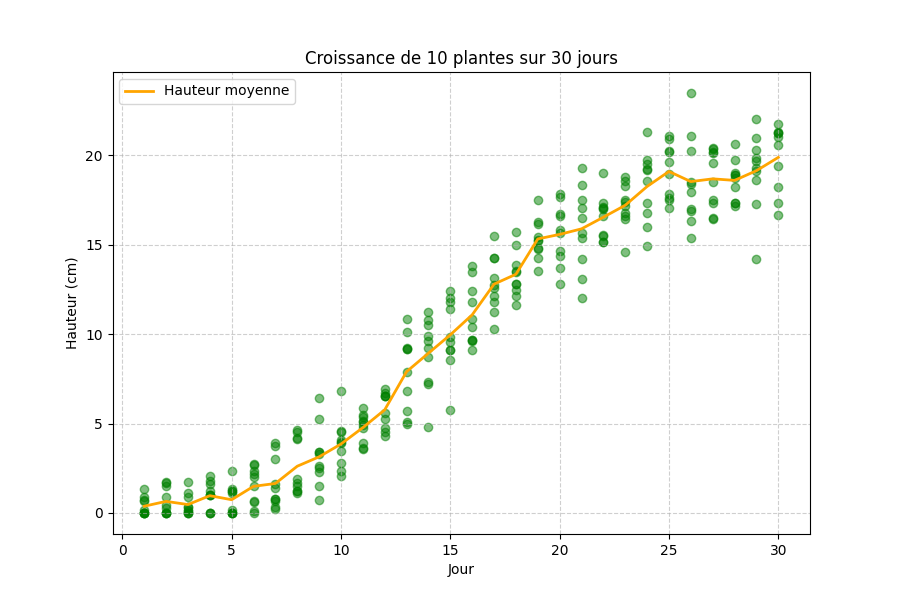
Étape 1 - Tracer une seule plante
Commencez par tracer uniquement les points de plante1 en vert semi-transparent, sans ligne entre les points.
Vérifiez que votre graphique ressemble aux mesures de la première plante avant de continuer.
Étape 2 - Tracer les 10 plantes
Ajoutez les 9 autres plantes de la même façon. La fonction plot(...) doit être appelée une fois par plante (10 appels au total).
Étape 3 - Calculer et tracer la moyenne
Créez une liste moyennes contenant la moyenne des 10 plantes pour chacun des 30 jours, puis tracez-la comme une courbe (avec une ligne).
- La transparence des points peut être déterminée avec le paramètre
alpha(ex :alpha=0.50). - Pour la courbe des moyennes, créez une nouvelle liste représentant la moyenne de chacun des 30 jours.
Les données nécessaires au graphique sont fournies sous la forme d’une liste par plante (1 donnée par jour) :
jours = list(range(1, 31)) #Génère une liste [1,2,3,...,28,29,30]
plante1 = [0.8976591646433567, 0.0, 0.15498324299736432, 0.9841528009536402, 0.15657204065985764, 0.0, 0.33447160605066895, 4.6283876633678975, 5.266817494776518, 3.4487692867267548, 5.870556870585399, 5.59921181812971, 9.151254660249002, 7.310614349370278, 9.851989318343366, 13.824188176315175, 15.464723326276136, 15.702426828326931, 13.512838407325102, 12.809356526359828, 17.47960344645509, 15.123420443868309, 17.40785829723269, 19.197800939941423, 20.154793311136707, 17.915665513991193, 20.104929315636344, 17.305250783347308, 19.13156508363107, 21.033513462238393]
plante2 = [0.17528353328795931, 0.2756336458541735, 0.0, 0.0, 0.0, 0.6309221590379746, 3.727550566214523, 1.2508511778721294, 0.7024180814306074, 6.830442869157721, 4.936682177229124, 4.5291192276271754, 4.990690106855183, 9.895431855587745, 11.417271004590937, 10.827200698671112, 12.598193409811389, 12.815001837722994, 16.14637147427025, 14.621077844225155, 17.03212243808826, 17.027520550344995, 16.747459643059045, 19.755682219447348, 20.9180585108655, 23.47304450933025, 17.30950120875156, 17.337504826772005, 19.26714999504858, 21.294379182578343]
plante3 = [0.7102632701578836, 0.0, 0.0, 0.0, 2.3343028391462797, 2.3438873675900336, 0.6454097889242174, 1.0996724026369975, 3.286045694345812, 3.9285399427808274, 3.612599736185482, 4.30020407797379, 9.145504683557949, 9.21225840090138, 8.562279898630978, 10.377545561479028, 10.300619634750328, 12.13895510845491, 14.769665211706135, 13.690346592845321, 15.37871243532946, 16.583317142828676, 16.57879523525781, 16.756826717506286, 17.604537555459814, 18.40131885619254, 16.404259701325834, 18.89079355214781, 20.288042085972553, 18.21005148218242]
plante4 = [0.0, 0.0, 0.8973792501708838, 0.9830097528856888, 0.0, 0.6461179782755417, 0.23226953686786578, 1.2472478853272517, 6.401366814252393, 2.0415819065854146, 3.891611111275125, 5.262117713514414, 7.876585352377606, 7.183706437052258, 12.426333923266526, 9.649513617333888, 12.73628479093696, 12.478132650678955, 15.249038804916301, 17.805230262139887, 13.063427000000233, 15.159135971994353, 17.14983145120984, 21.307851142556363, 17.03068748570027, 20.253810785360578, 19.569583288170133, 19.743382094110608, 22.00312569974368, 21.748919012129882]
plante5 = [0.6694150780194975, 1.4938014956025913, 0.35368890690893984, 0.9833023284099253, 1.2338260363941644, 2.192373222056616, 0.7787428769386353, 1.6909990215262607, 3.4065845701224866, 4.510530462984979, 4.769874841771353, 6.539463845509872, 10.129871941734269, 11.25078568737028, 12.01651914074369, 9.673096507429102, 11.77202031960022, 14.999346444191085, 14.834671920744888, 15.668917765971251, 15.638377444681467, 19.014525684346527, 16.407694562665597, 18.564642981001583, 17.46831271855271, 16.90077670848018, 20.338978550282203, 18.906724587915743, 19.694358440253918, 16.657933007109023]
plante6 = [1.3443398103456938, 1.7153571861619716, 0.1333277692479119, 1.6103108806176778, 0.0, 2.6826886678064543, 0.7904991374065058, 4.151998225725303, 1.508265561315599, 3.980472455562051, 5.12564841025743, 6.54192202156568, 9.19733810691179, 10.520195804652623, 9.10149309227341, 13.48939226520939, 13.149708808238799, 13.883893735070835, 15.228942187800202, 17.639327729443565, 18.317677985660385, 15.481336669078772, 18.548569162881705, 19.176333920189357, 17.836996378597085, 21.095745501671274, 20.171253471005997, 19.018100870312136, 17.274245444905446, 21.26052545093896]
plante7 = [0.0, 0.8985906272911144, 0.0, 2.0769771214349646, 0.0, 0.1303882294417198, 3.0373598089846636, 4.5034510344243515, 2.6102761908237677, 4.0807103767398845, 5.082159908953121, 6.926619478650151, 6.845441288816597, 10.789809579653474, 9.57315458379442, 9.12607939931834, 14.263096787065773, 11.63195582037034, 14.232154873258024, 15.820119635528503, 19.262088637822018, 15.523011851191633, 17.47956143053687, 17.34668556294283, 19.63177817156293, 16.291851406997555, 20.408500890879306, 18.695461783200003, 20.966068097868853, 20.542745168091884]
plante8 = [0.0, 0.0, 0.31593716941831607, 1.797879409074148, 1.3549021087528006, 2.72834888395552, 3.8987228957550815, 1.4887672079330272, 2.5269437973885465, 2.3589672604919345, 5.361937377304439, 6.7009581034667764, 5.728281913775275, 8.740111897509529, 11.79561232423084, 12.380547993337167, 12.103145069789937, 13.47668835211402, 16.290659431434516, 14.372002381487956, 16.470123949718353, 17.309302440725823, 14.597188305730064, 15.981267855499347, 18.953169075105787, 16.98465673667939, 18.473607004645785, 18.227860154572642, 14.21517584840647, 21.26330654419327]
plante9 = [0.0, 0.4522723346745793, 1.7586043686210397, 0.0, 1.2458737753703606, 2.015879463453331, 1.417370812307034, 1.8886807926980338, 2.2707244139301315, 2.7734256465247826, 5.501813520535498, 4.751188398387352, 10.846530040610622, 4.8128866460687805, 9.089459498762263, 11.772422596289898, 11.254134423545405, 13.530654216426512, 17.50499431491864, 16.576957278084116, 11.990172734262561, 16.994063860033176, 18.276243579795942, 19.50467136528814, 20.242796584353783, 18.524683668288525, 17.51022351284659, 17.155392328472765, 18.613109151742346, 17.347847505152078]
plante10 = [0.0, 1.6617879828120876, 1.1114070518778814, 1.2413536244030396, 1.0957815500862658, 1.5336617782080486, 1.6312859846759336, 4.19868256424098, 3.416719289385172, 4.608614661530128, 3.5593769395445642, 6.521317626985673, 5.077549860821263, 9.603200324467075, 5.755340324739416, 9.639255450256496, 14.271414716495176, 12.778076460254391, 15.402533086111394, 16.708734436876853, 14.17417569230928, 17.100934078054095, 18.80519666846201, 14.897059850615431, 21.046899131076906, 15.375114293061099, 16.463903627318345, 20.611482792264987, 19.857870964605823, 19.38782379439097]

#Liste contenant les données des 10 plantes (30 données par plante)
plantes = [plante1, plante2, plante3, plante4, plante5,
          plante6, plante7, plante8, plante9, plante10]
Nuage de points avec Matplotlib, multiples appels à plot(), calcul de moyennes par index
✏️ Exercices sur papier
Faites ces exercices d'abord sur papier (ou dans un éditeur de texte simple) et sans aucune documentation, comme à l'examen.
Vous pouvez valider votre réponse dans PyCharm à la fin — un luxe que vous n'aurez pas le jour de l'examen, d'où l'importance de vous entraîner sans lui.
Dessinez sur papier, approximativement, le graphique qui serait produit par l'exécution du code ci-dessous.
N'exécutez pas le code avant d'avoir terminé votre dessin !
import matplotlib.pyplot as plt

transport = ["Bus", "Voiture", "Vélo", "Skateboard", "Trottinette", "Marche"]
etudiants = [40, 30, 20, 15, 10, 5]

plt.bar(transport, etudiants)

plt.title("Comment les étudiants viennent au cégep")
plt.xlabel("Mode de transport")
plt.ylabel("Nombre d'étudiants")

plt.show()
📁 Créez un fichier r09_graphique_main.py pour valider votre réponse en exécutant le code.
Lecture de code Matplotlib, plt.bar(), anticipation du résultat d'un graphique
Écrivez sur papier ce qui sera affiché dans la console par l'exécution du code ci-dessous.
N'exécutez pas le code avant d'avoir terminé vos réponses !
virus_a = {"T", "G", "Uroboros"}
virus_b = {"G", "C", "Las Plagas"}

virus_a.add("T")
virus_a.add("C")

print(len(virus_a))
print("Uroboros" in virus_b)
print(virus_a & virus_b)
print(virus_a - virus_b)
print(virus_a | virus_b)
📁 Créez un fichier r09_comprehension_set.py pour valider votre réponse en exécutant le code.
Ensembles (set), unicité des éléments, add(), len(), opérateur in, union, intersection, différence
Écrivez sur papier ce qui sera affiché dans la console par l'exécution du code ci-dessous.
N'exécutez pas le code avant d'avoir terminé vos réponses !
joueur = {
    "pseudo": "Sakura99",
    "score": 4200,
    "niveau": 12,
    "inventaire": ["clé", "herbe verte"]
}

joueur["score"] = joueur["score"] + 300
joueur["inventaire"].append("ruban encreur")
joueur["region"] = "QC"

print(joueur["pseudo"])
print(joueur["score"])
print("niveau" in joueur)
print("clé" in joueur)
print(len(joueur))
print(joueur["inventaire"])
📁 Créez un fichier r09_comprehension_dict.py pour valider votre réponse en exécutant le code.
Dictionnaires (dict), accès par clé, modification d'une valeur, ajout d'une nouvelle clé, liste comme valeur, opérateur in, fonction len()
🎯 Solutions des exercices
Un solutionnaire possible pour chaque exercice est disponible en format vidéo avec des explications. Vous pouvez vous en servir pour comparer votre solution avec une solution possible jugée optimale et vous débloquer après un long moment bloqué sur un exercice (ex. 20 minutes) et après avoir utilisé le débogueur pour essayer par vous-même de trouver le problème.
Il est tout à fait normal que certains problèmes demandent du temps, de la réflexion, et parfois même un peu de frustration. C’est précisément dans ces moments d’effort que l’apprentissage s’ancre réellement.
Consulter un solutionnaire avant d’avoir tenté l’exercice par soi-même, ou le parcourir trop rapidement, revient à court-circuiter le processus d’apprentissage. Ce n’est pas simplement contre-productif, c’est pédagogiquement désastreux.
En sautant l’étape de la réflexion personnelle, on prive son cerveau de l’occasion de construire des connexions durables. Et à force de répéter ce réflexe, on risque de passer à côté des compétences essentielles, ce qui peut mener à des échecs plus tard, même si tout semble facile sur le moment. Alors oui, prenez le temps. L’erreur fait partie du jeu. C’est en cherchant, en tâtonnant, en doutant, qu’on devient réellement compétent. Le solutionnaire doit être un outil de validation, pas un raccourci.
🔨 Solution des exercices de création :
- Affichage des virus - liste simple
- Affichage des virus - listes parallèles
- Affichage des virus - liste à 2 dimensions
- Manipulation de listes par compréhension
- Manipulation d'ensembles
- Dictionnaires - Dictionnaire imbriqué
- Jeu de devinette amélioré
- Graphique - Courbe simple
- Graphique - Températures annuelles
- Graphique - Barres et moyennes
- Graphique - Populations par saison
- Graphique - Nuage de points et courbe